최근 개최된 HPE Discover 키노트에서 Antonio Neri 회장은 한 문장으로 인프라 시장의 패러다임을 정의했습니다.
“AI 혁신의 진정한 시작과 끝은 결국 네트워크다.”
시장의 시선은 온통 어떤 GPU가 더 빠른지, 혹은 어떤 거대언어모델(LLM)이 더 똑똑한지에만 쏠려 있는 듯하지만, 아무리 뛰어난 연산 칩을 보유하고 있더라도 이를 유기적으로 엮어줄 동맥이 부실하다면 AI Factory는 멈춰 설 수밖에 없습니다. 안토니오 네리 회장의 선언처럼 이 거대한 AI 워크로드들을 ‘지속 가능하고’, ‘수익성 있게’ 운영하기 위한 물리적 기반에 주목해야 하는 이유입니다.
많은 이들이 AI 네트워킹이라고 하면 데이터 센터 내부의 초고속 스위치(Backend Fabric)만을 떠올립니다.
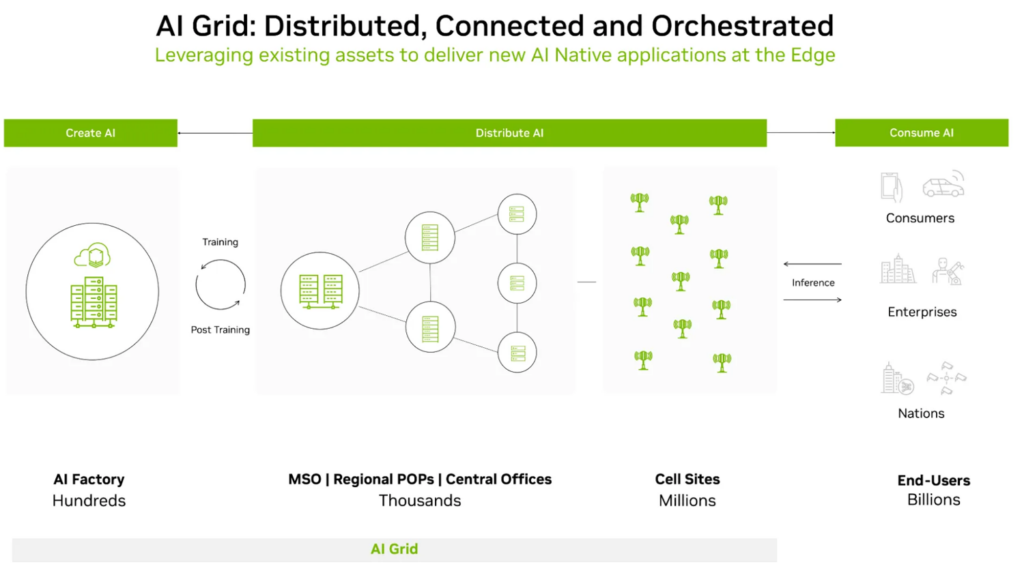
하지만 AI가 데이터 센터라는 거대한 공장(AI Factory)을 넘어, 사용자와 데이터가 존재하는 에지(Edge) 영역으로 분산되는 ‘AI Grid’ 시대로 접어들면서, 광역 네트워크(WAN)의 가치가 완전히 재조정되고 있습니다.
그래서 이번 블로그에서는 왜 엔비디아의 생태계를 품으면서도 결국 전체 AI 완성도를 결정짓는 것은 HPE Networking인지, 그리고 이것이 왜 토큰 경제학(Tokenomics)과 직결되는지 구조적으로 짚어보겠습니다.
데이터 센터의 한계를 넘어: 왜 ‘AI Grid(분산형 인프라)’인가?
하나의 거대한 데이터 센터에 수만 개의 GPU를 밀집시키는 전통적인 ‘AI Factory’ 모델은 공간, 그리고 무엇보다 전력(Power) 공급의 임계점에 봉착했습니다. 대규모 LLM 학습을 위해 수백 메가와트(MW)의 전력을 단일 부지에 공급하는 것은 불가능에 가깝습니다.
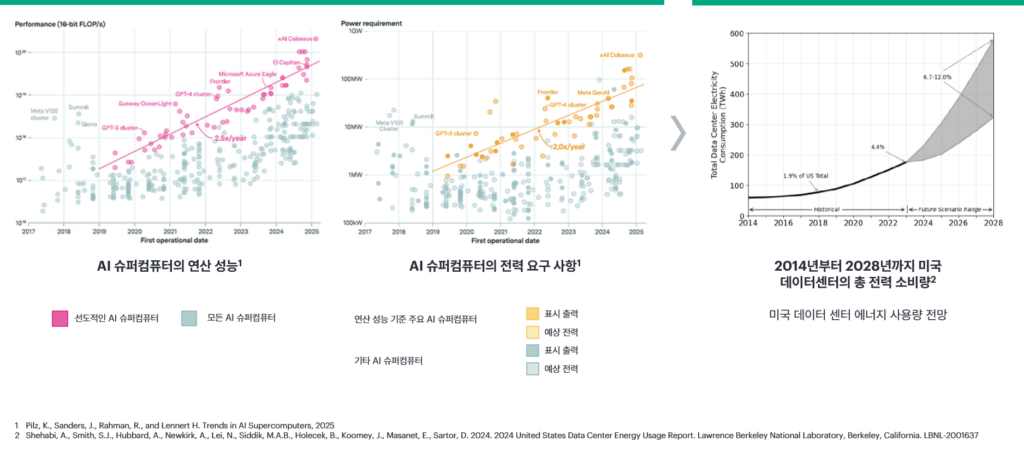
결국 해답은 인프라의 분산 및 그리드화(AI Grid)입니다.
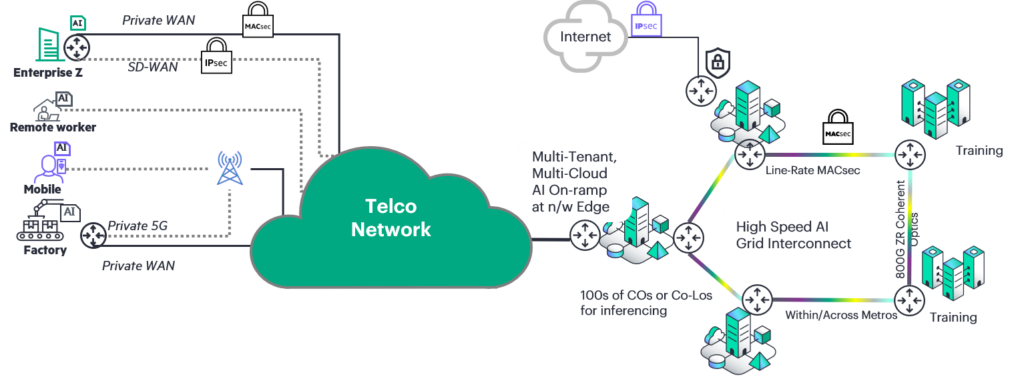
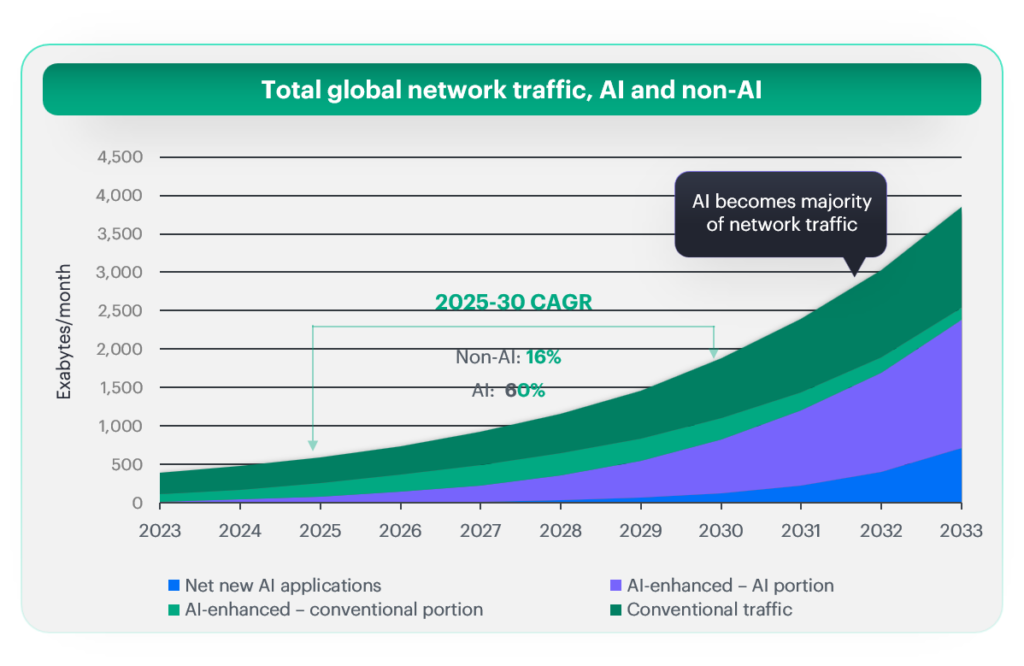
수백 킬로와트(KW) 규모의 분산된 에지 데이터 센터나 통신사 국사(Central Office)의 기존 자산(공간, 전력, 광케이블)을 활용해 AI 인프라를 유기적으로 연결하는 것입니다. Omdia 조사에 따르면, AI 채택 기업의 87%가 이미 에지 추론(Edge Inferencing)을 구현하고 있거나 계획 중이며, 이 트래픽은 향후 3년 내에 5배 이상 성장하여 2031년경에는 전통적인 데이터 트래픽을 추월할 것으로 전망됩니다.
리프-스파인의 Spectrum-X 배치: 엔비디아 정책과 에코시스템의 냉혹한 현실
HPE의 AI Grid 레퍼런스 아키텍처(HPE e2e AI Grid Solution)를 보면 한 가지 묘한 지점이 발견됩니다.
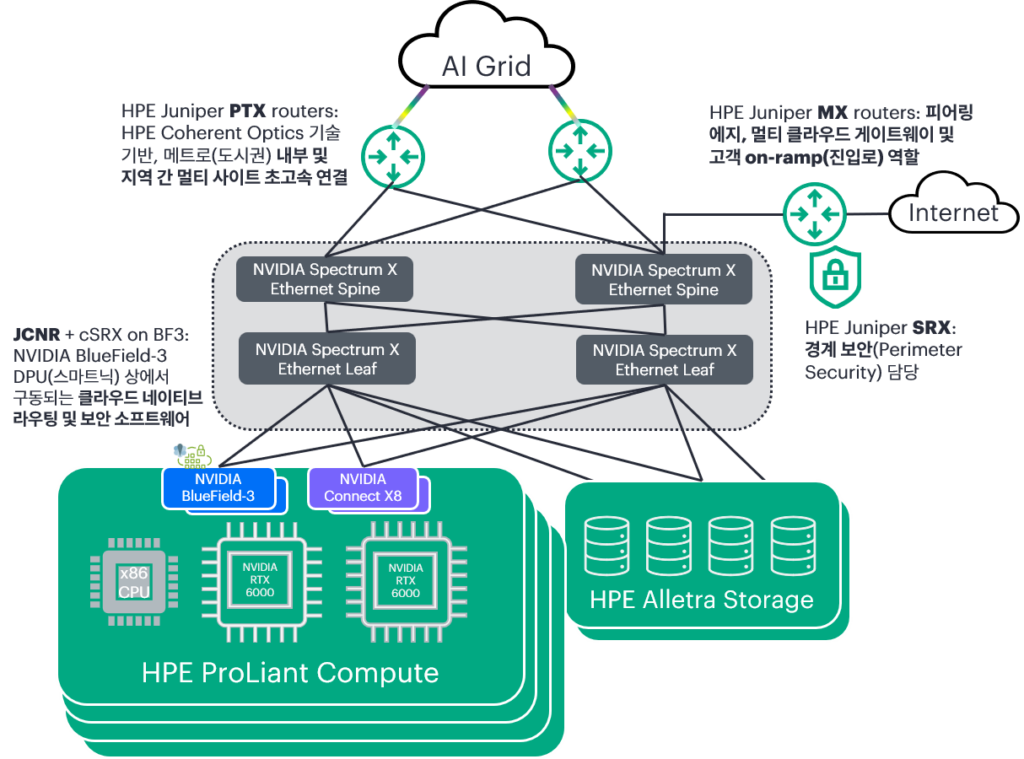
HPE가 주니퍼(Juniper)를 인수하며 업계 최고 수준의 QFX 스위치 라인업을 보유하게 되었음에도 불구하고, 데이터 센터 내부 GPU 백엔드(리프-스파인) 영역에는 엔비디아의 Spectrum-X가 자리 잡고 있다는 점입니다.
이는 엔비디아가 짠 판(AI Grid 생태계)과 하드웨어 인증 정책상 어쩔 수 없는 최선의 선택에 가깝습니다.
- 하드웨어 레벨의 강력한 종속성: 엔비디아가 제안하는 고성능 AI Factory 규격을 충족하고 정식 기술 지원(NVIDIA-Certified)을 받으려면, 서버 내부의 BlueField-3 DPU/SuperNIC와 하드웨어 레벨에서 완벽하게 맞물리는 Spectrum-X 배치가 반강제적인 필수 요건이 됩니다.
- 대체 불가능한 독점 기술: 일반 이더넷 스위치(QFX 등)를 이 자리에 넣어도 링크는 뜨겠지만, 엔비디아가 독점적으로 제공하는 패킷 단위 동적 라우팅(Adaptive Routing)과 초저지연 혼잡 제어(Congestion Control) 알고리즘을 100% 활용할 수 없습니다. 결국 GPU가 노는 병목(Tail Latency)이 발생해 비싼 AI 인프라의 가성비가 바닥을 치게 되므로, 백엔드 리프-스파인만큼은 엔비디아의 정책적 패키징을 그대로 수용할 수밖에 없는 구조인 것입니다.
HPE는 이 냉혹한 생태계적 현실을 영리하게 받아들이고, 대신 데이터 센터 외부와 내부를 잇는 전 영역에 주니퍼의 강력한 라우팅/보안 포트폴리오를 전면 배치하는 최적화 전략(Tiering)을 세웠습니다.
진짜 ‘HPE의 판’은 WAN에서 시작된다: 네트워크 레이어별 완벽한 역할 분담
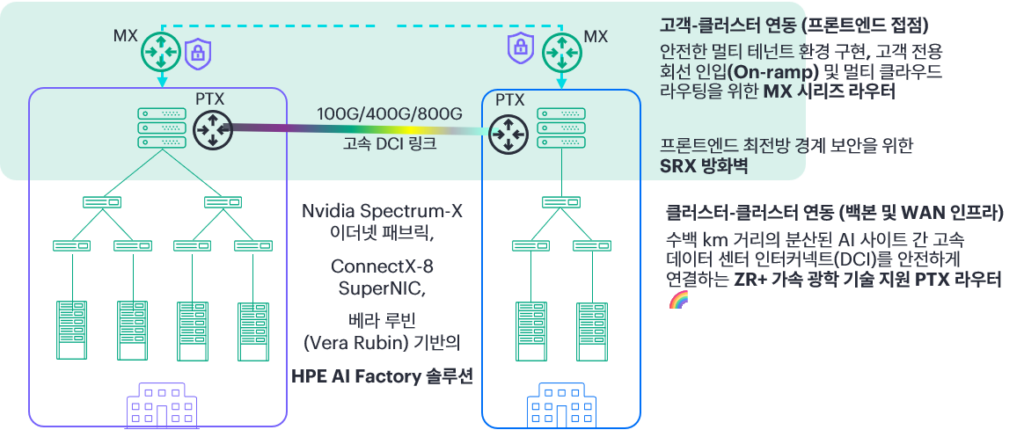
위 아키텍처 구조도에서 볼 수 있듯이, 단일 AI Factory 내부의 긴밀한 연산은 엔비디아 Spectrum-X에 맡기되, 이를 외부 세계 및 또 다른 AI 클러스터와 안전하게 묶어주는 거대한 고속 도로망은 철저하게 HPE Networking의 주니퍼 솔루션이 통제하고 있습니다.
각 레이어별 장비들의 구체적인 역할과 기술적 통찰을 정리하면 다음과 같습니다.
| 네트워크 레이어 | 적용 솔루션 | 핵심 역할 및 기술적 통찰 |
| GPU Backend 패브릭 (Intra-Site) | NVIDIA Spectrum-X (SN5610) | 엔비디아 정책 기반의 영역. GPU 간 대규모 데이터 동기화 및 초저지연 RoCE 환경 제공. |
| Cluster-to-Cluster interconnect (Inter-Site WAN) | HPE Juniper PTX 시리즈 (PTX10002-36QDD 등) | “WAN을 제2의 AI 패브릭으로 변모시키는 핵심 영역”. 분산된 AI 사이트 간 고속 데이터 센터 인터커넥트(DCI)를 담당하며, 고밀도 800GE 및 ZR/ZR+ 가속 광학 기술을 통해 수백 km 떨어진 GPU 자원을 단일 가상 클러스터처럼 묶어줌. |
| Customer-to-Cluster On-Ramp (Frontend / Edge) | HPE Juniper MX 시리즈 (MX301 / MX304 등) | 멀티 테넌트(Multi-tenant) 슬라이싱 및 보안 접속 edge 역할. 수많은 기업 고객이나 엔드 유저가 인프라에 접근할 때 대규모 VRF, 라우팅 테이블, 오버레이 터널을 안전하고 정교하게 격리·제어. |
| Perimeter Security | HPE Juniper SRX 시리즈 (SRX 4700 등) | AI 팩토리 전면에서 회선 속도(Line-rate)의 MACsec 암호화 및 인라인 IPsec, DDoS 방어 등을 수행하여 프론트엔드 보안성 완비. |
전력(Power) 공급의 한계로 인해 단일 부지에 수만 개의 GPU를 밀집시키는 전통적인 대형 데이터 센터 모델은 한계에 부딪혔습니다. 분산된 에지 인프라를 그리드화(AI Grid)하여 유기적으로 연결해야만 하는 시점에서, 백엔드를 제외한 외부 연결망과 프론트엔드 전체를 장악하는 주니퍼의 고성능 WAN 기술력이 HPE AI 솔루션의 진짜 뼈대가 되는 이유입니다.
추론 disaggregation(Prefill vs Decode)과 토큰 경제학(Tokenomics)
AI 서비스 공급자(CSP에서 AI SP로의 진화)에게 가장 중요한 지표는 ‘토큰당 비용(Cost per Token)’과 ‘초당 토큰 처리량(Tokens/sec)’입니다. 이를 결정짓는 AI 추론(Inference) 단계는 크게 두 가지 과정으로 나뉩니다.
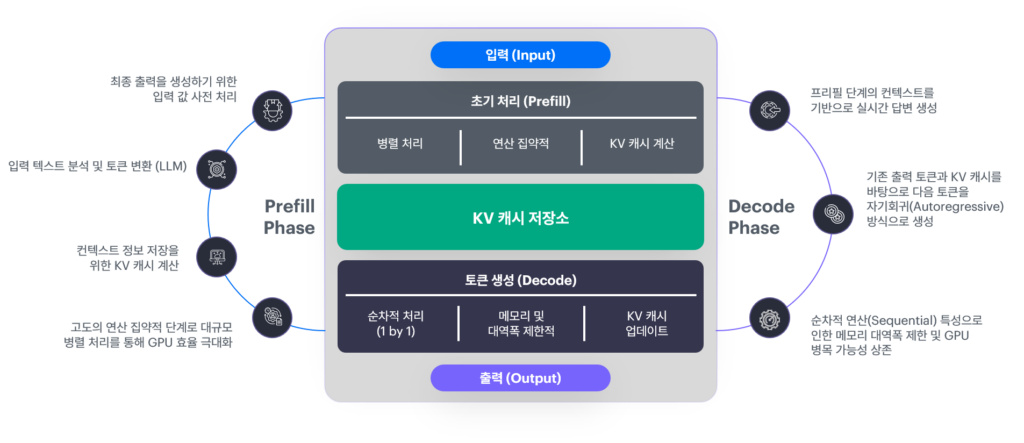
보시는 것처럼 AI 추론은 ‘초기 처리(Prefill)’와 ‘토큰 생성(Decode)’이라는 완전히 성격이 다른 두 단계로 쪼개집니다.
- 프리필(Prefill)은 대규모 병렬 처리가 일어나는 ‘연산 집약적’ 구간이고,
- 디코드(Decode)는 한 글자씩 순차적으로 출력(자기회귀)하는 ‘메모리 대역폭 제한적’ 구간입니다.
만약 이 두 단계를 하나의 GPU 박스 안에서 한꺼번에 처리하려고 하면 어떻게 될까요?
무거운 연산(Prefill)을 하느라 메모리 효율(Decode)이 떨어지고, 반대로 토큰을 한 글자씩 뽑아내느라(Decode) 비싼 GPU의 아까운 연산 코어들이 놀게 되는(Prefill 병목) ‘상호 간섭과 효율 저하’가 발생합니다.
서비스 공급자 입장에서 이는 곧 ‘토큰당 단가 상승’이라는 경영학적 재앙으로 이어집니다.
HPE Networking이 제시하는 돌파구는 이 단계를 WAN을 통해 통째로 분리(Disaggregation)하는 것입니다.
병렬 연산 파워가 강력한 대형 AI 팩토리에서 Prefill을 처리해 KV 캐시를 빠르게 계산한 뒤, 이 데이터만 HPE Juniper PTX의 초고속·초저지연 WAN 패브릭을 통해 사용자와 가장 가까운 에지(Edge) 인프라로 전송하는 것이죠. 그리고 에지 단에서 Decode만 전담하여 토큰을 끊김 없이 사용자에게 뿌려줍니다.
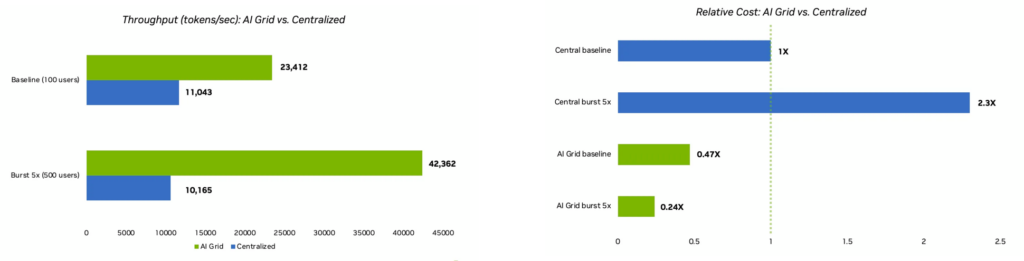
이 아키텍처가 실현되었을 때 비로소 중앙 집중형 인프라 대비 320% 높은 토큰 처리량과 90%의 비용 절감(0.24X 수준)이라는 압도적인 토큰 경제학(Tokenomics) 수치가 완성되는 것입니다.
퍽(Puck)이 갈 곳을 향해 스케이트를 지치십시오
“AI adoption is rapidly evolving the networking landscape.
Are you skating to the puck or ponder where the puck is going to be?”
아이스하키의 전설 웨인 그레츠키의 명언처럼, 지금 AI 인프라를 준비하는 기업들은 아이스하키 퍽이 현재 있는 곳(단순 GPU 추가 및 내부 리프-스파인 경쟁)이 아니라, ‘앞으로 퍽이 갈 곳(분산된 AI Grid와 WAN 혁신)’을 바라보아야 합니다.
HPE는 하드웨어 컴퓨터와 고성능 Alletra 스토리지, 그리고 엔비디아의 연산 플랫폼을 주니퍼의 통신사급 고성능 라우팅 스택(PTX/MX/SRX)과 유기적으로 통합하여 단일 창(Single-pane of glass)으로 관측하고 관리할 수 있는 엔드투엔드(E2E) AI Grid 솔루션을 완성했습니다.
기존의 전력과 공간 자산을 토큰 경제학 기반의 고수익 인프라(Metered Tokens-as-a-Service)로 전환하고 싶으시다면, 이제 AI의 두 번째 패브릭인 WAN 인프라 혁신을 고민할 때입니다. 안토니오 네리 회장의 말처럼, 결국 AI의 진정한 차별화는 네트워크에서 시작되니까요.