2026년 9월 2일, HPE와 오라클(Oracle)이 기가와트(GW) 규모의 AI 인프라 확장을 위한 전략적 협력을 대폭 확대한다고 공식 발표했습니다.
오라클 클라우드 인프라스트럭처(OCI)의 차세대 AI 슈퍼클러스터 전반에 HPE 네트워킹(HPE Networking) 솔루션을 다년에 걸쳐 글로벌 규모로 전면 배치하는 것이 골자입니다. 특히 HPE가 오라클에 자사 보통주 매수 청구권(Warrant)을 부여할 정도로 양사의 결속은 단순한 벤더-고객 관계를 넘어선 전략적 동맹의 형태를 띠고 있습니다.
엔지니어링과 비즈니스 관점에서 이번 발표가 갖는 무게감은 남다릅니다.
AI 클러스터의 전유물처럼 여겨지던 인피니밴드(InfiniBand)의 벽을 깨고 “하이퍼스케일러의 초대형 AI 패브릭 역시 이더넷으로 완벽히 수렴하고 있다”는 사실, 그리고 HPE가 AI 데이터센터(AIDC) 네트워킹을 프론트엔드부터 백엔드까지 ‘풀스택(Full-Stack)’으로 완결할 수 있는 독보적 역량을 증명했다는 점입니다.
분기점에 선 AI 패브릭: 왜 인피니밴드에서 이더넷(RoCEv2)인가?
AI 워크로드, 특히 초거대 언어 모델(LLM)의 분산 학습 환경에서 네트워크는 더 이상 단순한 데이터 전송 통로가 아닙니다.
컴퓨팅 파워 그 자체를 결정짓는 핵심 컴포넌트입니다.
분산 학습 과정에서 수만 개의 GPU는 필연적으로 All-Reduce와 같은 집합 통신(Collective Communication)을 끊임없이 수행합니다. 이때 가장 치명적인 문제가 바로 Tail Latency(꼬리 지연)와 동기화 배리어(Synchronization Barrier)입니다.
단 하나의 링크에서 패킷 드롭이나 마이크로버스트로 인한 지연이 발생하면, 나머지 수만 대의 GPU가 단 하나의 플로우를 기다리며 연산을 멈추고 공회전(GPU Idle)하게 됩니다.
이는 GPU 유효 활용률(MFU, Model FLOPs Utilization)의 급격한 저하이자 토큰당 생산 비용의 급증으로 직결됩니다.
초기에는 무손실(Lossless)과 초저지연을 보장하는 인피니밴드가 사실상 표준으로 자리 잡았으나, 기가와트(GW) 단위로 인프라가 팽창하면서 명확한 한계에 부딪혔습니다.
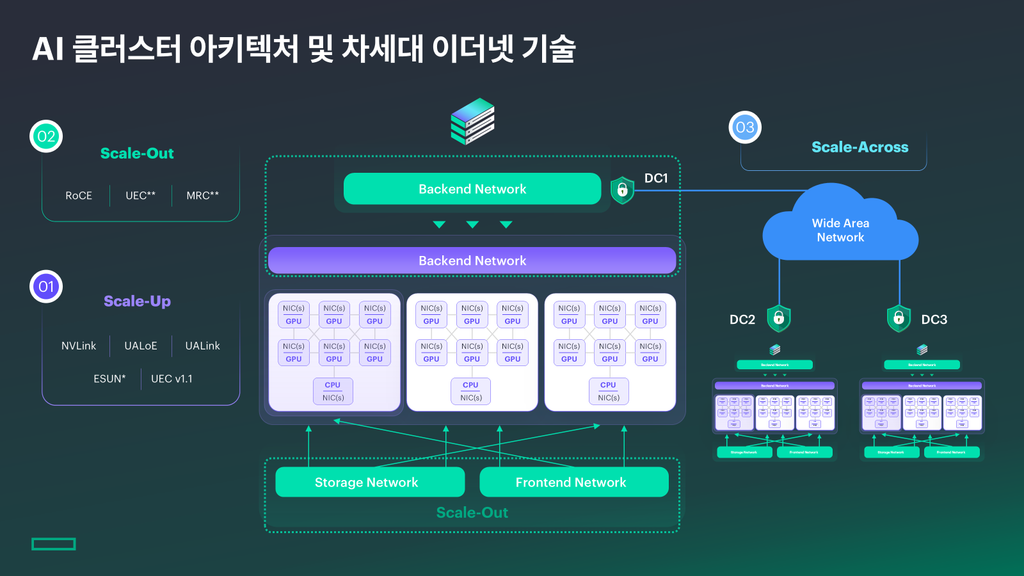
- 특정 벤더 종속(Vendor Lock-in): 단일 공급업체에 의존하는 폐쇄형 생태계의 공급망 리스크와 기형적인 TCO 구조
- 스케일아웃(Scale-Out)의 물리적 한계: 수십만 개 이상의 노드를 묶을 때 발생하는 패브릭 복잡성과 비용 부담
- 스케일어크로스(Scale-Across)와의 단절: 데이터센터 내부를 넘어 리전과 분산 거점을 잇는 광역 AI Grid 환경에서 기존 IP/이더넷 인프라와 단절되는 운영상 비효율
OCI가 이번 초대형 빌드아웃에서 선택한 해답은 RoCEv2(RDMA over Converged Ethernet v2) 기반의 고성능 이더넷 패브릭이었습니다. 울트라 이더넷(UET)이 지향하듯 표준 개방형 생태계의 탄탄한 공급망을 확보하면서도, 고급 혼잡 제어 기술을 통해 인피니밴드 수준의 무손실·초저지연 환경을 대규모로 구현해 낸 것입니다.
HPE가 제시하는 AIDC 패브릭의 ‘풀스택(Full-Stack)’ 아키텍처
이번 수주가 시장에 던지는 가장 강력한 메시지는, HPE가 “AIDC의 가장 깊숙한 GPU 백엔드 패브릭부터 최외곽 WAN/엣지 라우팅까지 단일 아키텍처로 완결할 수 있는 풀스택 포트폴리오”를 갖추었음을 입증했다는 점입니다.
기존의 많은 솔루션이 스파인-리프 스위칭에만 머물거나 특정 구간에 국한되었다면, OCI에 배포되는 HPE 네트워킹 아키텍처는 데이터센터의 모든 경계를 관통합니다.
| 아키텍처 도메인 | 적용 플랫폼 | 엔지니어링 역할 및 핵심 메커니즘 |
| AI Backend Fabric (GPU Cluster) | QFX Series | • 고밀도 400G/800G 포트 집적도 제공 • RoCEv2 기반 무손실 전송 최적화 (PFC, ECN) • 동적 부하 분산(Dynamic Load Balancing): 플로우 단위 쏠림을 방지하고 패킷 스프레잉/로드밸런싱 수행 |
| Regional DC Fabric (Spine/Leaf) | QFX & EX Series | • 리전 데이터센터 내부 컴퓨팅·스토리지 패브릭 연결 • 일관된 엔터프라이즈 운영 체계를 통한 운영 복잡도 최소화 |
| Edge & Inter-DC (Core Routing) | PTX & MX Series | • 초대형 AI 클러스터와 글로벌 리전, 고객 네트워크를 잇는 테라비트급 백본 라우팅 • 기가와트급 인프라를 지탱하는 고신뢰성 코어 트래픽 처리 |
| Telemetry & Observability (Intelligence) | Intelligent Telemetry | • 마이크로초(µs) 단위의 큐 적체(Queue Buildup) 및 패킷 손실 선제 감지 • 트래픽 불균형 및 광 트랜시버/케이블 하드웨어 열화 실시간 추적 |
백엔드 패브릭의 핵심: QFX 기반 동적 트래픽 엔지니어링
백엔드에 투입되는 최신 QFX 시리즈는 단순히 대역폭만 넓힌 것이 아닙니다.
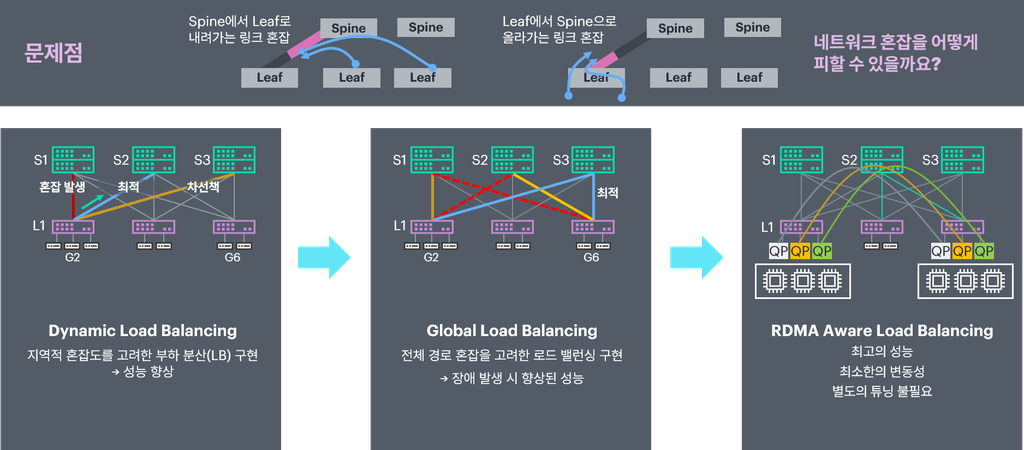
대규모 AI 워크로드의 불규칙한 트래픽 패턴(Incast 등)을 완화하기 위해 실리콘 ASIC 레벨에서 정교한 ECN 마킹과 PFC 데드락 방지, 그리고 하드웨어 기반 동적 부하 분산(DLB)을 수행합니다. 특정 링크에 코끼리 플로우(Elephant Flow)가 몰려 발생하는 해시 편향을 억제하고 패브릭 전체의 대역폭 활용도를 극한까지 끌어올리는 설계입니다.
GPU 공회전을 막는 무기: 심층 패브릭 텔레메트리
하드웨어 스펙보다 주목해야 할 대목은 양사가 강조한 “지능형 텔레메트리(Intelligent Telemetry) 기반의 가시성 협력”입니다.
수만 개의 GPU가 맞물려 돌아가는 클러스터에서는 물리적인 케이블 불량, 광 트랜시버의 미세한 신호 감쇄(Degradation), 간헐적인 CRC 에러 하나가 전체 AI 트레이닝 잡(Job)을 중단시키거나 수 시간씩 지연시키는 ‘사일런트 킬러(Silent Killer)’가 됩니다. 이는 토큰 경제학 관점에서 치명적인 자원 낭비입니다.
OCI와 HPE는 디바이스 및 패브릭 레벨에서 발생하는 트래픽 동작을 마이크로초(µs) 단위로 스트리밍 텔레메트리화하여 다음을 달성합니다:
- Queue Buildup 조기 경보: 버퍼가 넘쳐 패킷 드롭이 발생하기 전, 큐 적체 징후를 감지하여 트래픽 우회
- 사전 장애 조치(Proactive Remediation): 신호 품질이 저하되는 링크를 GPU 학습 세션 중단 없이 선제적으로 격리(Drain)
- GPU MFU 최적화: 네트워크 병목으로 인한 대기 시간을 원천 차단하여 인프라 TCO 극대화
“이더넷의 승리, 그리고 완성된 HPE 네트워킹의 힘”
이번 발표는 AI 인프라 시장의 판도가 어디로 향하고 있는지를 명확히 보여줍니다.
첫째, AI 백엔드 네트워크의 ‘이더넷 대세론’은 더 이상 미래형 가설이 아닌 현재진행형 표준입니다.
울트라 이더넷 컨소시엄(UEC)의 태동과 함께 시작된 거대한 흐름이, OCI라는 가장 공격적인 AI 클라우드 빌더의 대규모 채택으로 완전히 입증되었습니다.
둘째, HPE 네트워킹의 풀스택 파워 증명입니다.
엣지부터 코어, 그리고 AI 백엔드에 이르는 전 영역을 아우르는 단일 벤더 포트폴리오를 갖춘 기업은 시장에 극히 드뭅니다.
HPE는 이번 협력을 통해 하이퍼스케일러의 가장 까다로운 요구조건을 만족하는 ‘검증된 AIDC 풀스택 파트너’로서의 독보적인 포지셔닝을 확립했습니다.
기가와트급 AI 인프라의 시대, 네트워크는 더 이상 컴퓨트 자원을 연결하는 보조 수단이 아니라 AI 팩토리의 수율과 직결되는 핵심 엔진입니다. 그리고 그 중심에서 이더넷과 HPE 네트워킹의 풀스택 패브릭 기술이 산업의 새로운 기준을 세워가고 있습니다.