앞선 글에서 이번 HPE Discover 2026 키노트의 핵심 테마인 ‘자율주행 네트워크’를 가볍게 짚어보았는데요.
오늘은 그중에서도 가장 격렬한 기술 혁신이 일어나고 있는 영역, 바로 ‘AI 데이터 센터 네트워킹’을 깊숙이 파고들어 보려 합니다.
오늘날 엔터프라이즈 데이터 센터는 그야말로 운영상의 ‘임계점(Breaking Point)’에 도달했습니다.
쏟아지는 데이터와 복잡성 속에서 엔니지어들은 “데이터는 넘쳐나는데 정작 문제 해결을 위한 알맹이 정보는 부족한(Data rich, Information poor)” 역설적인 상황에 갇혀 있죠.
HPE가 이번 디스커버에서 제시한 해결책은 명확합니다.
“AI 운영도 결국 인프라의 ‘맥락(Context)’을 이해해야 성공한다”
타사처럼 사후에 모니터링 툴을 덕지덕지 붙이는 방식이 아닌, 근본부터 다른 HPE의 차세대 데이터 센터 자율주행 아키텍처의 3대 핵심 기둥을 공유합니다.
1. Context가 전부다: Graph DB 기반의 ‘진짜 AI Ops’
많은 네트워크 벤더들이 인공지능 어시스턴트를 말하지만, 인프라의 전체 구조와 관계를 모른 채 실시간 로그만 분석하는 AI는 오진을 내리기 쉽습니다.
HPE 데이터 센터의 독보적인 강점은 바로 Apstra Data Center Director에 있습니다.
- Apstra는 인프라의 상호 연결 관계를 인간의 뇌 신경망처럼 엮은 ‘컨텍스트 그래프 데이터베이스(Contextual Graph Database)‘ 위에 구축되어 있습니다.
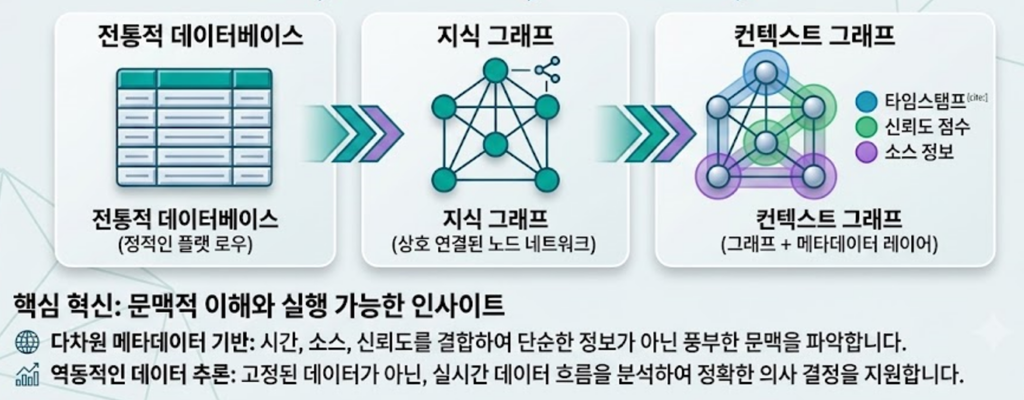
- 이를 기반으로 구동되는 Marvis AI 어시스턴트(Agentic AI)는 수백만 건의 글로벌 기술 지원(TAC) 사례와 실시간 스위치 텔레메트리, 애플리케이션 플로우를 이 ‘그래프 DB’와 연동하여 사람처럼 추론합니다.
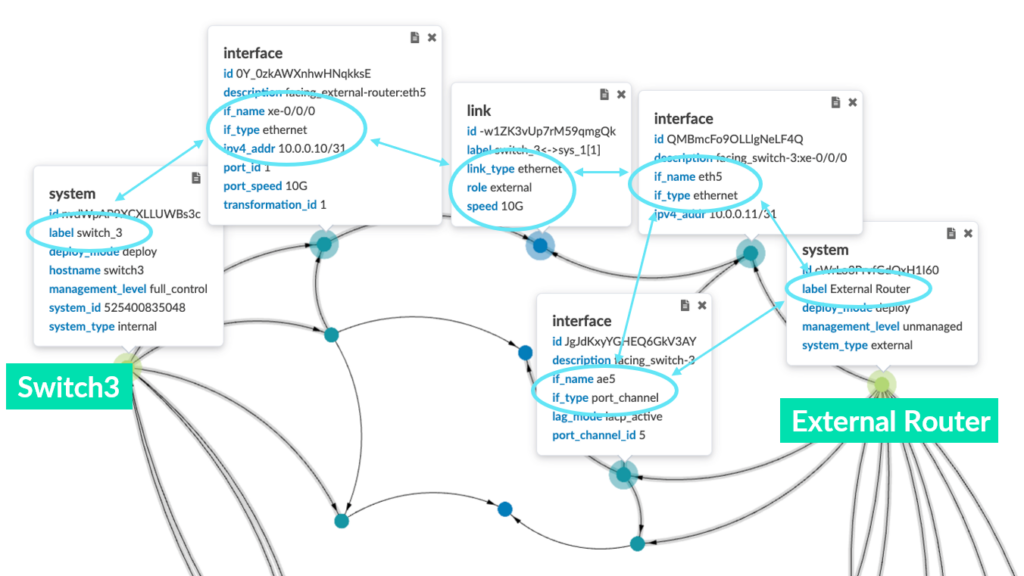
- 결과적으로 원인 분석(RCA)에 며칠씩 걸리던 복잡한 데이터 센터 장애를 단 몇 분 만에 송곳처럼 정확하게 짚어내고 해결책을 제시합니다. 맥락(Context)을 아는 AI와 모르는 AI의 격차가 여기서 발생합니다.
2. 예측 관제와 디지털 트윈: 장애가 발생하기도 전에 막는 기술
이번 발표에서 데이터 센터의 안정성을 극적으로 끌어올린 소프트웨어 혁신 기능 두 가지가 큰 주목을 받았습니다.
30개 이상의 지표를 분석하는 ‘예측형 유지보수(Predictive Maintenance)’
단순히 “장비가 죽었다”는 알람을 울리는 시대는 끝났습니다.
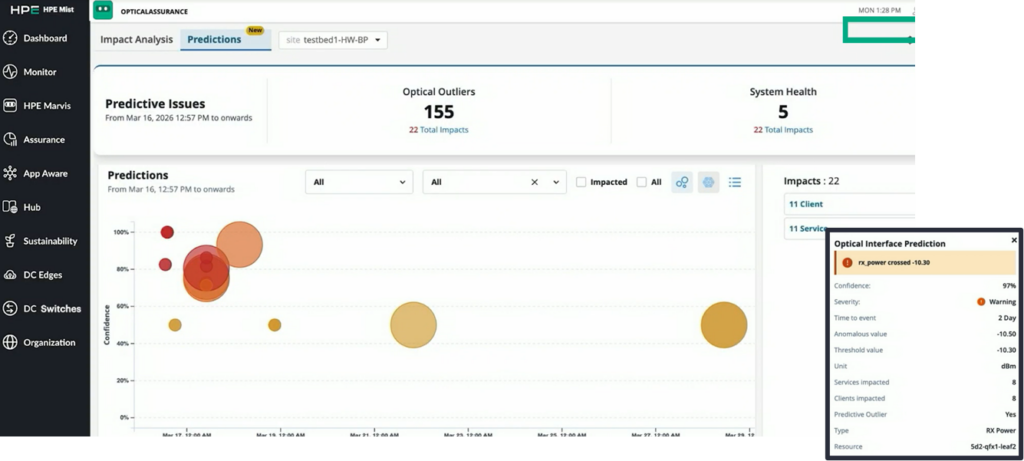
전압, 전류, 온도, CRC 에러 등 스위치와 광학 모듈(Optics)의 30가지 이상의 미세한 데이터 트렌드를 AI/ML 모델이 상시 분석합니다. 이를 통해 하드웨어가 실제로 고장 나기 훨씬 전에 장애 시점과 영향 범위(Blast Radius), 신뢰도를 직관적인 시각화로 예고해 주어 선제적 조치를 가능하게 만듭니다.
상시 가동되는 디지털 트윈 ‘Marvis Minis’
실제 운영 트래픽에 영향을 주지 않으면서 네트워크가 정상인지 매 순간 확인할 수 있다면 얼마나 좋을까요?
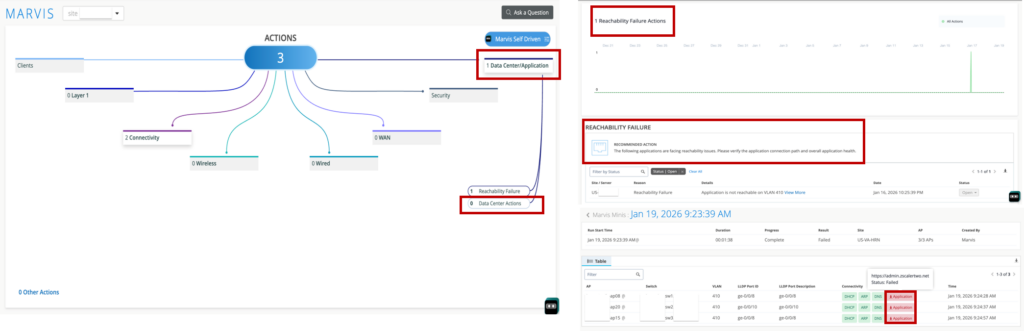
데이터 센터용 Marvis 플랫폼은 ‘Marvis Minis’라는 디지털 경험 트윈 에이전트를 구동합니다.
이 가상 에이전트들이 24시간 내내 데이터 센터 패브릭 사이에서 모의 트래픽을 흘리며 경로와 서비스 상태를 지속적으로 검증(Continuous Validation)합니다. 잠재적 병목 구간을 사용자가 느끼기 전에 먼저 찾아내 청소하는 역할입니다.
3. ESG 시대의 필수품: ‘처방형 지속가능성 분석 (Sustainability Analytics)’
인프라 엔지니어들의 또 다른 골칫거리는 AI 워크로드로 인한 폭발적인 전력 소비와 비용입니다.
HPE는 단순히 전력 그래프를 보여주는 수동적인 모니터링을 넘어 ‘최적화(Prescriptive Optimization)’를 도입했습니다.
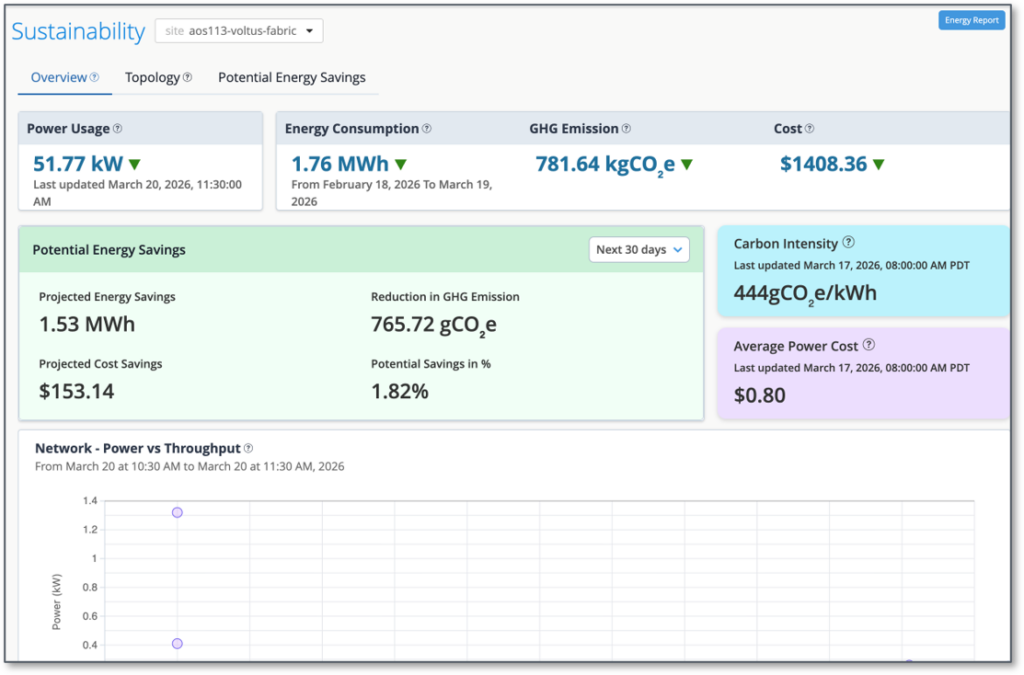
- AI가 데이터 센터 내부를 실시간으로 모니터링하다가, 현재 트래픽 대비 놀고 있는 라인 카드, 유휴 패킷 포워딩 엔진(PFE), 비활성 포트를 스스로 찾아냅니다.
- 그리고 단순 차트 출력이 아닌, “이 포트와 엔진을 슬립 모드로 전환하면 서비스 품질(SLA) 저하 없이 전력 비용을 이만큼 아낄 수 있습니다”라는 구체적인 가이드와 최적화 단계를 처방(Prescriptive)해 줍니다. 성능과 친환경 가치 두 마리 토끼를 잡은 셈이죠.
4. Cross-Domain: 인프라 사일로를 부수는 하이브리드 클라우드 통합
네트워크 팀, 서버 팀, 스토리지 팀이 따로 노는 ‘사일로(Silo)’ 현상은 데이터 센터 민첩성을 떨어뜨리는 주범입니다.
HPE는 이를 극복하기 위해 크로스 도메인 통합을 선언했습니다.
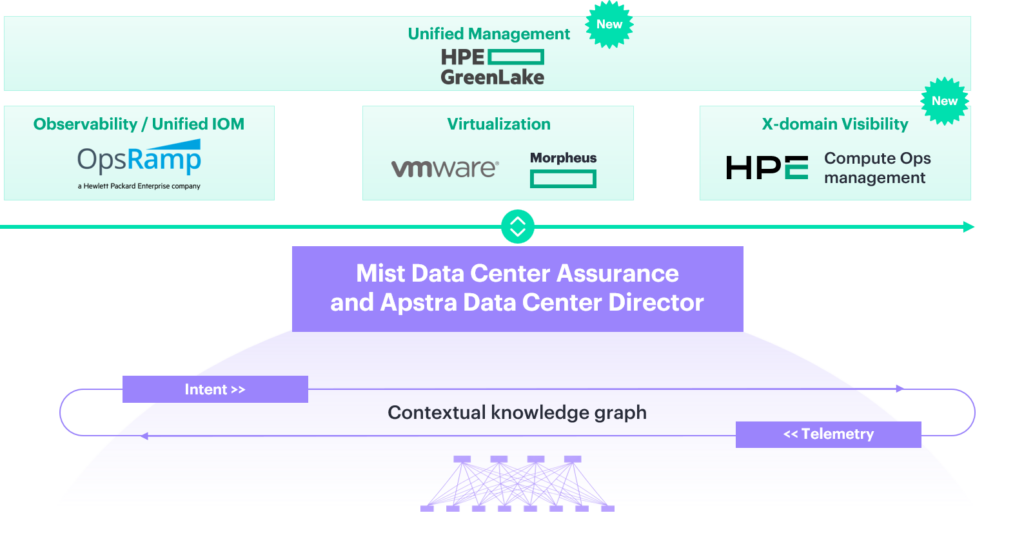
HPE Networking의 Data Center Assurance 기술이 HPE GreenLake 및 HPE Compute Ops Management와 전격 통합됩니다. 이제 네트워크 단의 AI 텔레메트리와 서버 하드웨어 관리 콘솔이 하나로 묶여, 하이브리드 클라우드 전 영역에서 발생하는 인프라 문제를 단일 컨트롤 타워(Single Point of Control)에서 즉시 교차 분석하고 해결할 수 있는 진정한 풀스택 인프라 생태계가 열렸습니다.
한 줄 평: GPU가 1분 1초도 쉬지 않도록
AI 데이터 센터의 성패는 결국 “GPU가 네트워크 대기 시간 때문에 멍 때리는 시간(Idle Time)을 얼마나 줄이느냐”에 달려 있습니다. 하드웨어 스펙이 아무리 좋아도 네트워크가 삐끗하면 수십억 원짜리 GPU 클러스터가 멈춰 서기 때문입니다.
이번에 발표된 Apstra의 ‘AI Job Awareness(AI 워크로드 인지)’ 기술은 네트워크가 실시간으로 거대 AI 학습 패턴을 감지하여 라우팅과 로드 밸런싱을 역동적으로 최적화합니다. 맥락을 이해하는 AI Ops 소프트웨어와 수랭식 하드웨어가 결합된 HPE의 이번 아키텍처는 인프라 사일로에 갇혀 고통받던 엔지니어들에게 가장 명확한 이정표를 제시하고 있습니다.
데이터 센터의 진정한 자율주행, 이제 멀지 않은 미래가 아니라 바로 지금 눈앞의 현실입니다.