AI 데이터센터(AIDC) 인프라를 구축할 때 GPU 스펙만큼 신중하게 고려해야 하는 핵심 요소가 바로 네트워크 스위치에 탑재된 ASIC(Application-Specific Integrated Circuit, 주문형 반도체) 칩셋입니다.
상용 실리콘(Merchant Silicon) 기반 스위치 환경에서 처리 대역폭, 버퍼 구조, 패킷 제어 방식, 지연 시간(Latency)의 상당 부분은 어떤 ASIC을 채택했는가에 의해 결정됩니다.
1. Tomahawk vs. Trident: AIDC에서의 명확한 역할 분담
데이터센터 스위치 실리콘의 양대 축인 Broadcom의 Tomahawk와 Trident는 태생적인 설계 철학부터 적용 영역까지 명확히 구분됩니다.
| 비교 항목 | Broadcom Tomahawk (TH4 / TH5) | Broadcom Trident (Trident 5-X12) |
| 설계 목적 | Ultra-High Throughput & Spine Fabric | Programmability & Intelligent Leaf/ToR |
| 핵심 강점 | 압도적인 포트 밀도 및 원시 대역폭 (Raw Throughput) | 패킷 식별, 인캐스트 방지, 트래픽 엔지니어링 |
| 파이프라인 | 단순화된 고속 고정 포워딩 파이프라인 | 유연한 프로그래머블 파이프라인 (NPL 지원) |
| 온칩 지능 | 순수 고속 스위칭 집중 | NetGNT (On-chip Neural Network Engine) 탑재 |
| 주 타깃 영역 | AI 학습(Training) 백엔드 패브릭 | AI 추론(Inference) & 프론트엔드 패브릭 |
- Tomahawk (학습 백엔드 최적화):
수천 개의 GPU가 파라미터를 동기화하는 대규모 동기식 트래픽(All-to-All, All-Reduce) 환경에서는 파이프라인이 단순하고 대역폭이 극대화된 Tomahawk 기반 스파인/백엔드 스위치가 제 성능을 발휘합니다. - Trident (추론 및 하이브리드 워크로드 최적화):
사용자 인바운드 쿼리, 벡터 DB 검색(RAG), 스토리지 기반 모델 로딩 등 비동기적이고 다양한 크기의 패킷이 뒤섞이는 구간에서는 지능적인 패킷 처리와 텔레메트리 기능을 갖춘 Trident 5가 필수적입니다.
2. Trident 5(TD5) 탑재: QFX5140-24CD8O의 구조적 특징
Broadcom의 최신 Trident 5-X12를 탑재하여 출시된 대표적인 플랫폼이 QFX5140-24CD8O입니다.
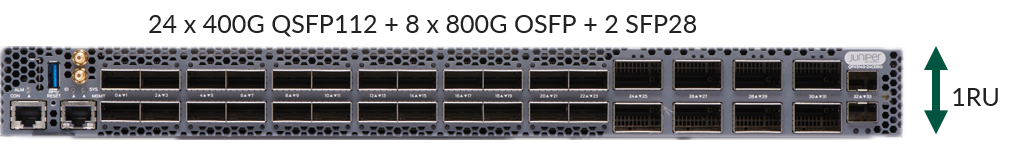
- 1RU 폼팩터 & 16Tbps 처리량: 112G PAM4 SerDes 기반으로 최신 가속기와의 인터페이스 효율 극대화
- 비대칭 I/O 포트 구성:24x 400G (QSFP112) 다운링크 + 8x 800G (OSFP) 업링크
- 유연한 브레이크아웃: 400G 포트를 최대 96x 100G(또는 멀티 브레이크아웃)로 나누어 기존 100G 노드와 차세대 400G 노드를 단일 섀시에서 수용
- 차세대 전송 프로토콜: 네이티브 RoCEv2 지원 및 차세대 UET(Ultra Ethernet Transport) 지원
특히 TD5에 내장된 NetGNT(Networking General-purpose Neural-network Traffic-analyzer) 엔진을 통해, 다수의 노드가 동시에 응답할 때 순간적으로 버퍼가 고갈되는 인캐스트(Incast) 현상을 실시간 감지하고 하드웨어 라인레이트 레벨에서 선제 완화합니다.
3. 실전 벤치마크로 본 추론 트래픽의 역설 (AMD MI300X 실증)
실제 프로덕션 추론 환경에서 네트워크는 어떤 역할을 할까요? 최근 공개된 AMD Instinct MI300X(8-GPU/노드) 기반 SGLang 및 Envoy 로드밸런서 테스트베드 실증 결과는 주목할 만한 인사이트를 제시합니다.
[ 클라이언트 쿼리 발생기 (GenAI-Perf) ]
                   ↓ (100G)
[ Envoy Proxy 로드밸런서 (Data Parallelism 분산) ]
                   ↓ (200G/400G)
[ QFX5140 Leaf / ToR (NetGNT 혼잡 완화) ]
     ├── Node 1: AMD MI300X (8 GPUs, SGLang Router) ⇄ [ GPUDirect Storage / RoCEv2 ]
     └── Node 2: AMD MI300X (8 GPUs, SGLang Router) ⇄ [ DeepEP / NIXL / NCCL 분산 추론 ]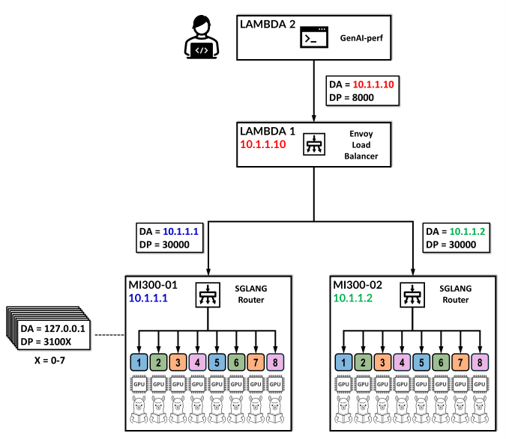
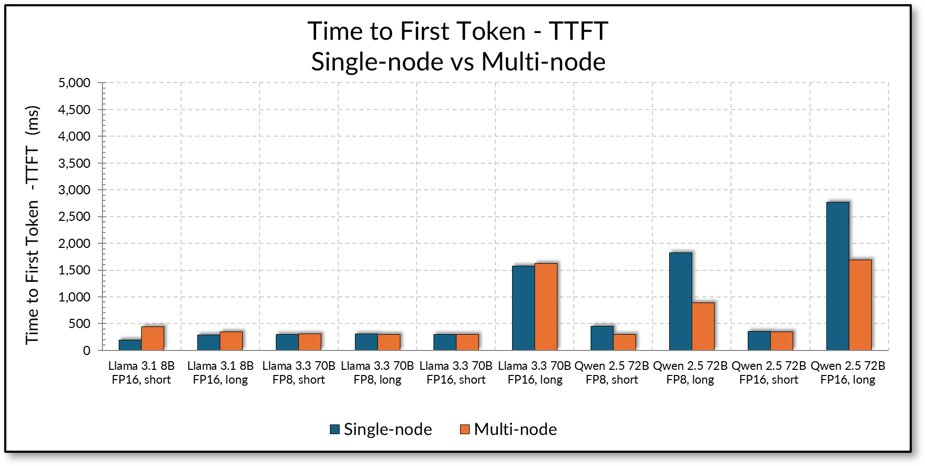
- 테스트 워크로드: Meta Llama 3.1 8B, Llama 3.3 70B, Qwen 2.5 72B (FP16 및 FP8 양자화 적용)
- 시나리오 구성: Short Context(100 In / 100 Out) 및 Long Context RAG 요약(1,500 In / 250 Out)
“GPU가 네트워크보다 먼저 포화되는데, 왜 400G 고속 패브릭이 필요할까?”
GenAI-Perf 측정 결과, GPU 활동률이 90~100%에 도달하며 멀티 노드 환경에서도 선형적인 토큰 처리량(Throughput) 확장을 보여주었습니다. 순수 텍스트 쿼리/응답 대역폭만 본다면 100G 링크로도 GPU의 연산 속도가 먼저 한계에 도달합니다.
그럼에도 QFX5140과 같은 고성능 400G 패브릭이 필수적인 이유는 프로덕션 AI 환경의 ‘트래픽 수렴(Convergence)’ 때문입니다.
- 복합 워크로드의 대역폭 슬라이싱: 프론트엔드 패브릭은 단순 쿼리 전달에 그치지 않고, 대용량 RAG 벡터 검색, 스토리지 기반 모델 가중치 로딩(GPUDirect Storage), Agentic AI 통신, 데이터 수집 워크로드가 단일 망에 뒤섞입니다. 400G 파이프라인 안에서 이 다양한 트래픽을 상호 간섭 없이 격리·할당해야 합니다.
- TTFT(Time To First Token) 방어: Long Context 및 RAG 쿼리의 프리필(Prefill) 단계에서 발생하는 버퍼 경합을 TD5의 NetGNT와 RoCEv2 혼잡 제어로 방어하여 첫 토큰 지연 시간을 밀리초 단위로 안정화합니다.
- 분산 추론(Expert Parallelism): MoE(Mixture of Experts) 모델 구동 시 노드 간 발생하는 DeepEP(DeepEveryParallel), NIXL, NCCL 기반의 분산 통신을 초저지연으로 처리합니다.
4. 동일 세대 실리콘/경쟁 제품군 대비 QFX5140의 실질적 경쟁력
시장에는 다양한 400G/800G 스위치와 동일한 상용 ASIC을 채택한 플랫폼들이 존재합니다. 그럼에도 QFX5140이 AI 추론 패브릭에서 확실한 차별점을 갖는 이유는 토폴로지 최적화와 소프트웨어 생태계의 완성도에 있습니다.
① 1U 비대칭 I/O 최적화 (토폴로지 효율성)
기존의 대다수 400G/800G 스위치는 32x 400G 또는 64x 800G의 대칭형 포트 구조를 채택해 리프 스위치로 배치할 때 업링크/다운링크 간의 오버스퀘어(Oversubscription) 비율 설계가 비효율적이었습니다.
QFX5140은 24개 다운링크(400G/100G)와 8개 800G 업링크를 1U 규격에 1:1 논블로킹 비율로 최적화하여 랙 상단(ToR) 공간과 전력 낭비를 줄였습니다.
② 검증된 마이크로서비스 NOS: Junos OS Evolved
하드웨어 ASIC의 성능이 아무리 뛰어나도, OS가 이를 유연하게 제어하지 못하면 기능이 제한됩니다.
- Junos OS Evolved는 리눅스 네이티브 마이크로서비스 구조로 동작하여, 개별 프로세스 장애 시에도 전체 제어 평면 중단 없이 즉각적인 격리 및 복구가 가능합니다.
- ASIC의 심층 텔레메트리 데이터를 고주파수로 스트리밍하여 실시간 AI 트래픽 분석에 즉시 반영할 수 있는 안정성을 제공합니다.
③ Apstra 기반의 Intent-Based 패브릭 자동화 및 옵저버빌리티
단품 스위치의 스펙 경쟁을 넘어, 패브릭 전체를 어떻게 운영하는가가 AIDC의 실제 TCO를 좌우합니다.
- 청사진(Blueprint) 기반 무중단 배포: 복잡한 RoCEv2 매개변수, PFC/ECN 버퍼 설정, EVPN-VXLAN 멀티테넌시 정책을 휴먼 에러 없이 패브릭 전체에 일관되게 배포합니다.
- 실시간 폐루프(Closed-loop) 검증: 인캐스트 발생 지점, 슬로우 드레인 노드, 비정상 패킷 드롭을 실시간 감지하고 원인을 추적하여 대규모 AI 추론 서비스의 다운타임을 방지합니다.
5. 엔드투엔드 AIDC 레퍼런스: Spine(TH) + Leaf(TD5)
HPE의 검증된 AI 아키텍처(Validated Designs)가 제안하는 표준 구성은 명확합니다.
- Spine 계층: Broadcom Tomahawk 기반 고밀도 스위치로 최대 대역폭과 백본 확장성 확보
- Leaf 계층: Broadcom Trident 5 기반 QFX5140으로 지능형 패킷 제어, 다종 트래픽 수렴, GPU/스토리지 정밀 연동 수행
결론: 실리콘 혁신과 패브릭 오케스트레이션의 결합
AIDC 네트워크는 무조건적인 대역폭 확장만으로 해결되지 않습니다.
학습 백엔드에는 Tomahawk의 원시 대역폭이, 추론 및 프론트엔드 패브릭에는 Trident 5의 온칩 신경망(NetGNT)과 정교한 트래픽 엔지니어링이 적재적소에 배치되어야 합니다.
QFX5140은 Trident 5라는 강력한 엔진 위에 Junos OS Evolved의 안정성과 Apstra의 패브릭 자동화 검증 능력을 결합함으로써, 엔터프라이즈 AI 추론 인프라를 위한 최적의 엔지니어링 해답을 제시하고 있습니다.