AI 모델 학습 시 네트워크는 더 이상 단순한 파이프가 아닙니다. 수만 개의 GPU가 데이터를 주고받는 집단 통신(Collective Communication) 환경에서는, 단 하나의 패킷 유실이 전체 학습 완료 시간(JCT)을 지연시키는 치명적인 병목이 됩니다.
작년 HPE Discover 바르셀로나에서 HPE와 VIAVI Solutions는 이더넷의 근본적인 체질 개선을 알리는 놀라운 시연을 선보였습니다.
오늘은 인피니밴드의 대항마로 떠오른 UEC(Ultra Ethernet Consortium)의 탄생 배경부터, 기존 RoCEv2의 한계를 완벽히 극복한 ‘패킷 트리밍(Packet Trimming)’ 기술과 최신 로드밸런싱 아키텍처까지 아주 깊숙이 파헤쳐 보겠습니다.
인피니밴드의 독점을 깨다: UEC의 등장과 미션
수만 개의 GPU를 연결하는 거대한 AI 데이터센터 네트워크 시장은 오랫동안 ‘인피니밴드(InfiniBand)’의 독무대였습니다. 무손실(Lossless)과 초저지연(Ultra-low Latency)이라는 강력한 무기가 있었기 때문이죠. 하지만 폐쇄적인 벤더 생태계, 천문학적인 구축 비용, 그리고 노드 수가 10만 개 이상으로 넘어갈 때 발생하는 확장성의 한계가 발목을 잡기 시작했습니다.
이에 대항하기 위해 2023년, HPE를 비롯해 Broadcom, Arista, Cisco, Intel, Meta, Microsoft 등 글로벌 IT 공룡들이 리눅스 재단 산하에 모여 UEC(Ultra Ethernet Consortium)를 결성했습니다.
이들의 목표는 단 하나입니다.
“이더넷 특유의 개방성과 경제성은 그대로 유지하면서, 인피니밴드를 뛰어넘는 AI 전용 전송 기술을 만들자.”
그리고 최근 발표된 UEC 1.0 규격을 바탕으로, 차세대 AI 패브릭의 핵심 표준인 UET(Ultra Ethernet Transport)가 마침내 세상에 모습을 드러냈습니다.
기존 이더넷(RoCEv2)의 치명적 아킬레스건
현재 AI 데이터센터 이더넷을 지탱하는 RoCEv2는 패킷 손실을 막기 위해 PFC(Priority Flow Control)와 DCQCN 메커니즘에 의존합니다.
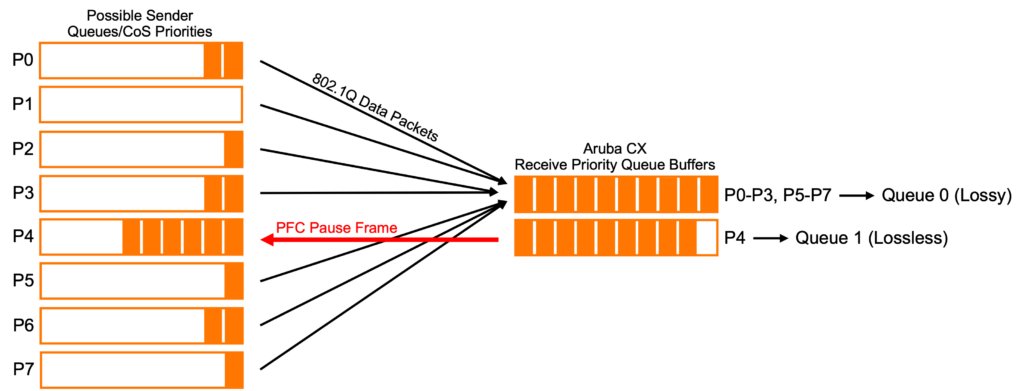
하지만 이 수동적인 혼잡 제어 방식은 규모가 커질수록 명확한 한계를 드러냅니다.
- 반응 속도의 한계 (지연): 스위치 버퍼가 차오르면 수신 측에 알리고, 수신 측이 다시 송신 측에 전송 속도를 줄이라고 요청하는 과정 자체가 너무 깁니다.
- 맹목적인 패킷 드롭: 트래픽이 임계치를 넘어 결국 스위치가 패킷을 버려야(Drop) 할 때, 기존 방식은 패킷을 말 그대로 흔적도 없이 ‘증발’시킵니다.
- 타임아웃(Timeout) 페널티: 송신 측 GPU는 자신이 보낸 데이터가 유실되었는지 알 길이 없습니다. 한참 뒤 타임아웃이 발생하고 나서야 재전송을 시작하므로, 그동안 수많은 GPU가 유휴 상태(Idle)로 멈춰 서게 됩니다.
기술 딥다이브: UET 패킷 트리밍(Packet Trimming)의 해부학
이러한 한계를 극복하기 위해 UET는 패킷을 맹목적으로 버리지 않습니다.
‘데이터는 버리되, 정보는 살린다’는 역발상 접근법인 패킷 트리밍을 도입했습니다.
이 기술은 네트워크 패브릭 내에서 다음과 같은 정교한 메커니즘으로 동작합니다.
| 단계 | 동작 주체 | 기술적 메커니즘 (How it works) |
| 1. 혼잡 감지 및 절삭 (Trim) | UET 스위치 | 스위치의 Egress 큐가 포화 상태에 도달하면, 스위치 ASIC은 패킷 전체를 버리는 대신 데이터 페이로드(Payload)만 잘라내고 기본 헤더(Header)는 보존합니다. |
| 2. 마킹 및 우회 (DSCP) | UET 스위치 | 잘려 나간 뼈대(Header) 패킷에 특수한 DSCP(우선순위 코드) 값을 마킹합니다. 이 패킷은 막혀있는 일반 데이터 큐가 아닌, 텅 비어있는 ‘최우선순위 큐’로 즉시 이동합니다. |
| 3. 초고속 전달 (Delivery) | 네트워크 패브릭 | 가벼워진 트리밍 패킷은 네트워크의 병목 구간을 하이패스처럼 통과하여 목적지 GPU 서버(NIC)에 빛의 속도로 도달합니다. |
| 4. 즉각적 인지 및 NACK | 수신 측 (Target NIC) | 수신 측은 도착한 패킷의 헤더를 분석하여 “정확히 몇 번 패킷이 유실되었는지” 즉시 파악합니다. 그리고 송신 측에 NACK(Negative Acknowledgment)를 보내 해당 패킷만의 신속한 재전송을 트리거합니다. |
💡 이 메커니즘의 핵심은 ‘혼잡 신호의 텔레메트리화’입니다.
타임아웃을 기다릴 필요 없이 서브 마이크로초(Sub-microsecond) 단위로 유실을 인지하고 복구함으로써, 패킷 재전송에 따른 대역폭 낭비를 막고 극도로 낮고 예측 가능한 지연 시간(Predictable Latency)을 보장합니다.
진화하는 트래픽 엔지니어링: GLB, RALB 그리고 패킷 스프레이
패킷 트리밍이 ‘사후 복구’를 책임진다면, 네트워크가 아예 막히지 않도록 트래픽을 지능적으로 분배하는 사전 예방(Traffic Engineering) 기술 역시 놀랍게 진화하고 있습니다.
단순히 스위치 포트의 상태만 보던 과거의 동적 로드밸런싱(DLB)을 넘어, 최근 AI 패브릭은 GLB와 RALB라는 강력한 무기를 장착했습니다.
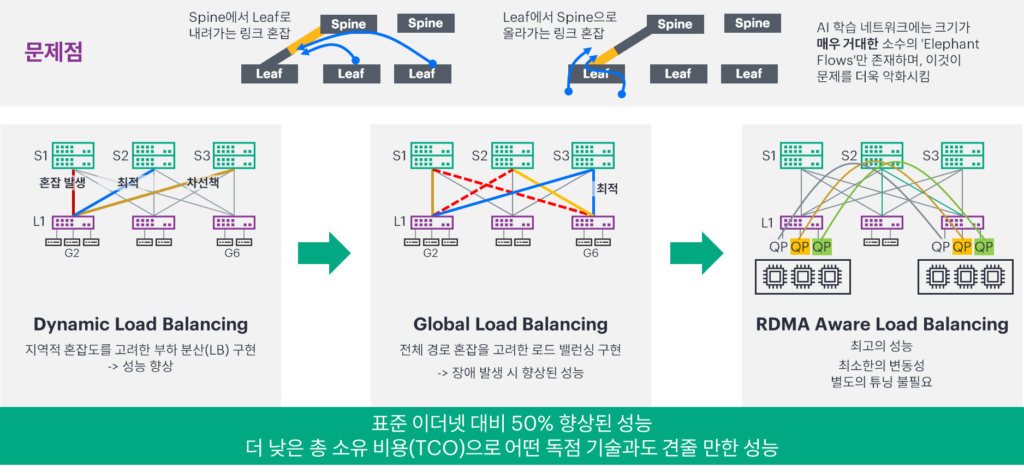
| 로드밸런싱 기술 | 관점 | 동작 핵심 | AI 네트워크에서의 역할 |
| DLB (Dynamic) | Local (스위치 관점) | 개별 스위치 내에서 링크의 사용량을 보고 덜 막히는 포트로 트래픽 분배 | 기본적인 1차 병목 회피 |
| GLB (Global) | Fabric (전체 망 관점) | 패브릭 전체의 텔레메트리를 수집해, 출발지부터 목적지까지의 End-to-End 최적 경로를 계산하여 분배 | 코어 스위치의 숨은 혼잡(Hidden Congestion) 사전 차단 |
| RALB (RDMA-Aware) | Protocol (애플리케이션 관점) | RoCEv2/RDMA 패킷의 헤더(QP 등)를 스위치가 직접 이해하고, 순서가 뒤섞이지(Out-of-order) 않도록 흐름(Flow) 단위로 안전하게 분배 | 레거시 RoCEv2 환경의 고질적인 드롭 문제 해결 |
이러한 최신 로드밸런싱 기술들은 UET의 전송 방식과 만나 완벽한 삼위일체를 이룹니다.
- [사전 조율] 스위치 패브릭은 GLB를 통해 네트워크 전체의 지도를 그리고, RALB를 통해 이종 워크로드 트래픽이 엉키지 않도록 스마트하게 길을 터줍니다.
- [대역폭 극대화] UET 송신 측은 패킷 스프레이(Packet Spraying)를 통해 잘 닦인 여러 가용 경로에 물뿌리개처럼 데이터를 동시에 흩뿌려 대역폭 효율을 100%로 끌어올립니다.
- [즉각 복구] 그럼에도 불구하고 발생하는 찰나의 충돌은 패킷 트리밍이 발동해 지연 없이 유실을 복구합니다.
이처럼 스위치의 지능형 라우팅과 UET의 혁신적인 엔드포인트 제어가 결합된 아키텍처야말로 100만 노드 확장을 가능케 하는 차세대 AI 데이터센터의 근간입니다.
HPE Discover 바르셀로나: 이론을 현실로 증명하다
이러한 UET의 혁신은 단순한 스펙 문서(Specification)에 머물지 않습니다.
HPE와 VIAVI Solutions는 이를 실제 하드웨어로 구현해 냈습니다.
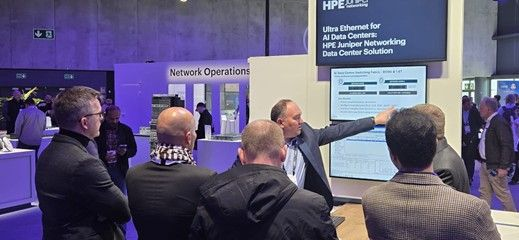
시연은 브로드컴의 Tomahawk 5 ASIC이 탑재된 Juniper QFX5240 스위치(800G 64포트)와 VIAVI B3 800G Appliance를 통해 진행되었습니다.
- 실시간 트리밍 검증: 극한의 스트레스(Stress) 시나리오에서도 QFX5240 스위치가 라인 레이트(Line-rate) 수준에서 패킷 트리밍을 수행하고 트래픽 처리량을 안정적으로 유지하는 것을 증명했습니다.
- 이종 워크로드의 공존 (Coexistence): 800G 포트를 통해 UET 트래픽과 기존 RoCEv2 트래픽이 동시에 포워딩되었으며, 놀랍게도 패킷 드롭이나 혼잡 전파(Congestion Propagation) 없이 두 프로토콜이 완벽하게 공존했습니다. 이는 레거시 인프라를 보호하며 점진적인 마이그레이션이 가능하다는 강력한 증거입니다.
- Job-ID 기반의 가시성: VIAVI의 고급 계측은 개별 작업(Job) 수준에서 레이턴시와 혼잡 원인을 상관 분석할 수 있는 심층 텔레메트리를 제공하여 AI 운영자에게 강력한 가시성을 쥐여주었습니다.
차세대 AI 데이터센터를 위한 블루프린트
AI 인프라 혁신은 끝이 없습니다.
곧이어 1.6Tbps 수냉식 이더넷 스위칭을 지원하는 브로드컴 Tomahawk 6 기반의 Juniper QFX5250 모델도 출격을 앞두고 있습니다.
HPE와 VIAVI의 협력은 업계에 명확한 메시지를 던집니다.
기존 인프라를 전면 교체(Rip and Replace)할 필요 없이, 가장 혼잡한 AI 코어부터 점진적으로 UET를 도입할 수 있다는 것입니다.
인피니밴드의 성능을 넘어서면서도 개방형 생태계의 경제성을 제공하는 Ultra Ethernet, 그 미래의 중심에 HPE와 UEC의 혁신이 있습니다.