지난 포스팅에서 우리는 인공지능(AI) 시대의 폭발적인 트래픽을 감당하기 위해, 기존의 느려터진 TCP와 까다로운 RoCEv2의 대안으로 등장한 UET(Ultra Ethernet Transport)의 탄생 이야기를 나누었습니다.
하지만 많은 분께서 “개념은 참 좋은데, 이게 진짜 실현 가능한 기술인가요? 언제쯤 우리 데이터센터에 들어오나요?”라는 질문을 하곤 합니다. 글로벌 컨설팅 그룹 맥킨지(McKinsey & Company)의 2026년 2월 최신 보고서에 따르면, “2030년이 되면 데이터센터 수요의 40% 이상을 AI 추론(Inference) 워크로드가 차지하며 매년 35%씩 폭발적으로 성장할 것”이라고 합니다.
이 말은 즉, 차세대 AI 네트워킹은 더 이상 먼 미래의 상상이 아니라, 2026년 현재 전 세계 데이터센터 현장에서 이미 벌어지고 있는 가장 뜨거운 현실이자 생존 전략이라는 뜻입니다.
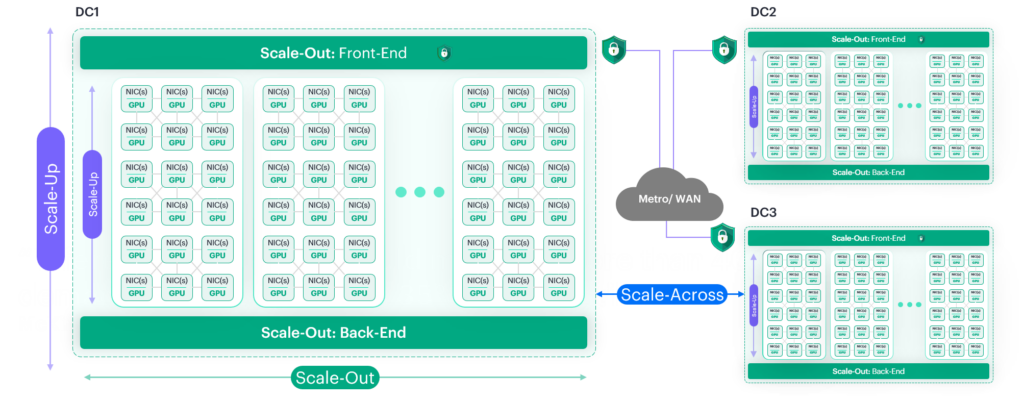
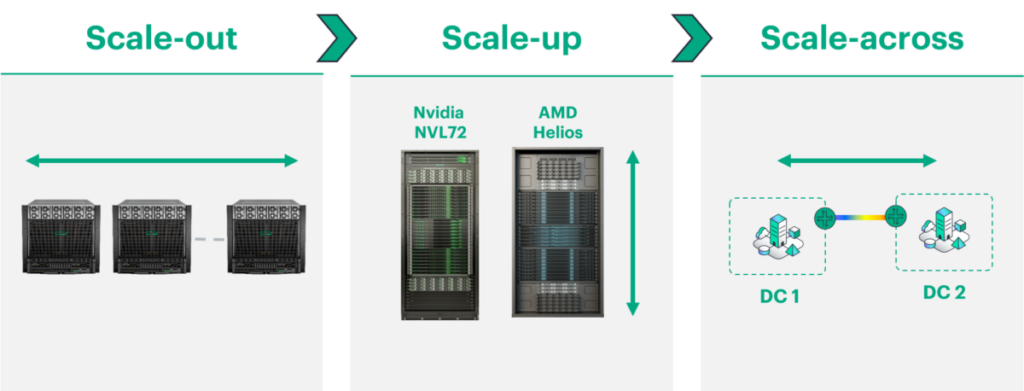
오늘은 AI 네트워킹의 3대 축인 Scale-Up, Scale-Out, Scale-Across라는 세 가지 퍼즐을 통해, HPE Networking의 최신 기술이 이 복잡한 인프라를 얼마나 쉽고 강력하게 풀어내고 있는지 살펴보겠습니다.
💡 잠시 리마인드! RoCEv2와 차세대 AI 이더넷 아키텍처는 뭐가 다를까?
본격적인 퍼즐을 맞추기 전에, 지난 시간에 다룬 RoCEv2와 이번 차세대 아키텍처의 결정적인 차이를 딱 한 가지만 짚고 넘어가겠습니다.
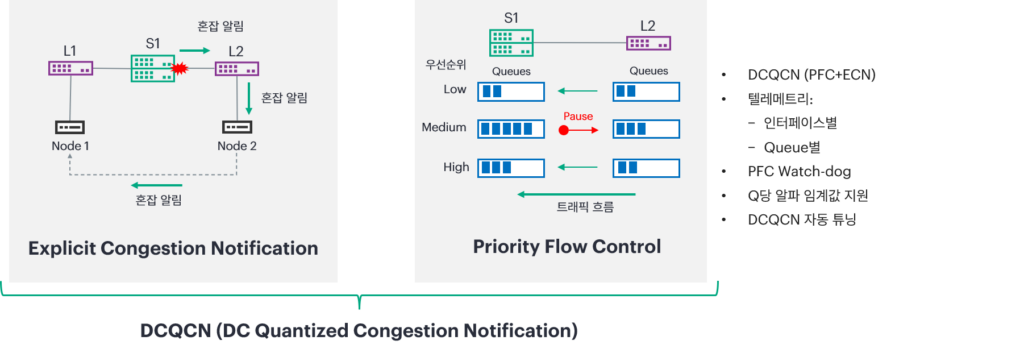
그림에서 보시듯, RoCEv2 환경에서는 도로가 막히기 시작하면 스위치가 목적지에 혼잡 알림(ECN)을 보내고, 목적지가 다시 출발지에 수신 속도를 줄이라는 CNP 패킷을 보내는 등 엄청나게 바쁜 혼잡 제어 루프(DCQCN)가 돕니다.
심지어 버퍼가 꽉 차기 직전이 되면 뒤쪽 스위치에 아예 차선을 막아버리는 ‘Pause(PFC 멈춤 신호)’를 보냅니다.
문제는 이 피드백이 한 바퀴 돌아서 반응하는 데 걸리는 시간(RTT)이 AI 트래픽의 폭발 속도보다 느리다는 점입니다. 결국 뒤따라오던 트래픽이 줄줄이 막히면서 도로 전체가 주차장처럼 마비되는 ‘PFC 데드락’ 현상이나 패킷 유실을 고질적으로 유발했습니다.
반면, 우리가 오늘 이야기할 UET 기반의 차세대 AI 이더넷 아키텍처는 이렇게 “도로를 막아서 유실을 막는” 미련한 방식을 쓰지 않습니다. “길이 막히면 패킷을 잘게 쪼개서 비어 있는 모든 차선으로 실시간 우회(MRC/스프레이)시키고, 만약 깨지면 엔드투엔드가 아니라 그 구간에서 바로 복구(LLR)한다”는 훨씬 지능적인 방식을 취하죠.
이 차이를 머리에 넣고, AI 네트워킹의 세 가지 퍼즐을 비유로 쉽게 풀어보겠습니다.
🧩 퍼즐 1. Scale-Out: 덤프트럭이 가득한 도로에서 ‘상습 정체’ 해결하기
어디를 연결하나? 서버와 서버, 스위치와 스위치 사이의 연결
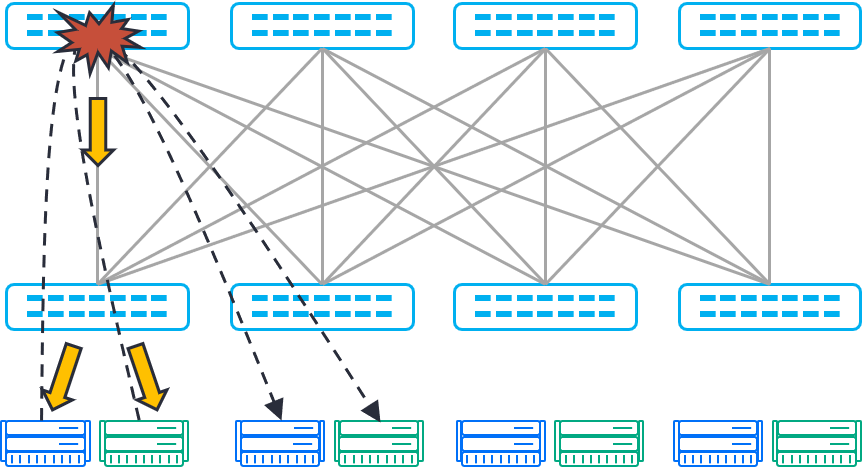
AI 학습 네트워크는 수만 개의 GPU가 동시에 하나의 거대한 덩어리 데이터를 주고받는 특성을 가집니다. 네트워킹 세상에서는 이를 ‘엘리펀트 플로우(Elephant Flows)’라고 부르는데, 쉽게 비유하자면 도로 위에 웅장한 대형 덤프트럭들이 가득 들어찬 상황입니다.
기존 데이터센터의 일반적인 내비게이션(Static ECMP 라우팅)은 미련하게도 이 덤프트럭들을 모두 하나의 차선으로만 몰아넣어 상습 정체와 패킷 유실을 유발하곤 했습니다.
이 문제를 해결하기 위해 최근 OpenAI를 비롯한 빅테크 기업들이 주목한 방식이 바로 Packet Spray(패킷 스프레이), 즉 UET 표준 기반의 MRC(Multi-path Reliable Connection) 기술입니다.
화물(데이터)을 패킷 단위로 아주 잘게 쪼개어 비어 있는 모든 차선으로 동시에 흩뿌려버리는 방식이죠.
하지만 이 방식은 도로 상황에 따라 택배 상자가 1번, 5번, 3번... 형태로 뒤죽박죽(Out-of-Order) 도착한다는 치명적인 부작용이 있습니다. 결국 이 뒤틀린 순서를 원래대로 맞추려면 서버 단에 ‘하드웨어 패킷 재정렬 기능’이 있는 값비싼 전용 고급 NIC를 강제하게 되므로, 특정 벤더의 독점 기술에 종속(Proprietary)되고 비용이 폭발하는 대가를 치러야 합니다.
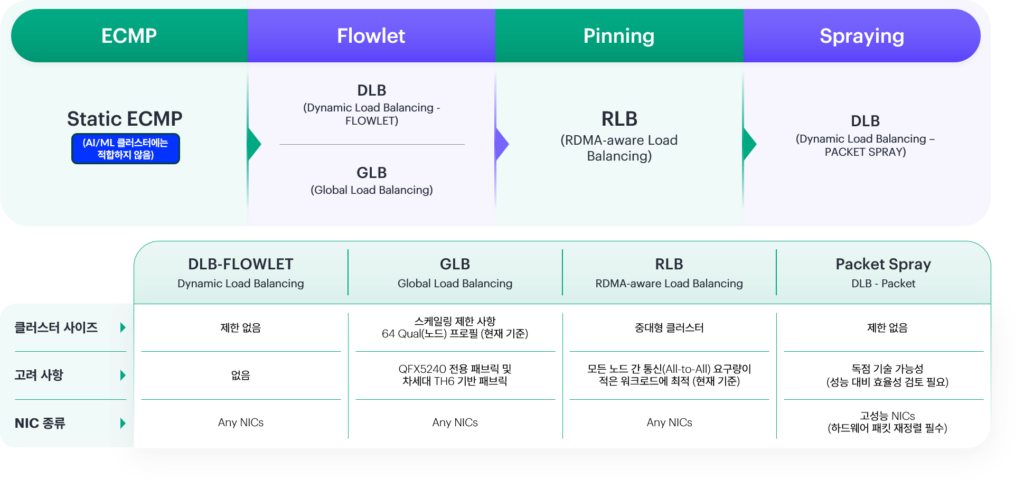
그렇다면 독점 기술 없이, 범용적인 인프라로 이 상습 정체를 해결할 방법은 없을까요? AI 백엔드 부하 분산 기술의 진화 지도를 보시면 해답이 보입니다.
AI 로드밸런싱 방식
표에서 보시는 것처럼 엔비디아조차도 인피니밴드의 공급망 한계와 폐쇄성을 극복하기 위해 이더넷 기반의 ‘스펙트럼-X(Spectrum-X)’ 패킷 스프레이 방식을 주력으로 밀고 있지만, 여전히 Advanced NIC라는 장벽이 존재합니다.
여기서 HPE가 제시하는 독보적인 정답이 바로 그래프 세 번째 칸에 위치한 RLB (RDMA-aware Load Balancing), 즉 ‘Pinning’ 방식입니다. 패킷을 무작정 쪼개어 스프레이로 뿌리는 대신, 주니퍼의 지능형 알고리즘이 RDMA 통신의 흐름을 정확히 인지하여 처음부터 혼잡이 전혀 없는 최적의 차선을 미리 지정(Pinning)해 묶어서 보내는 방식입니다.
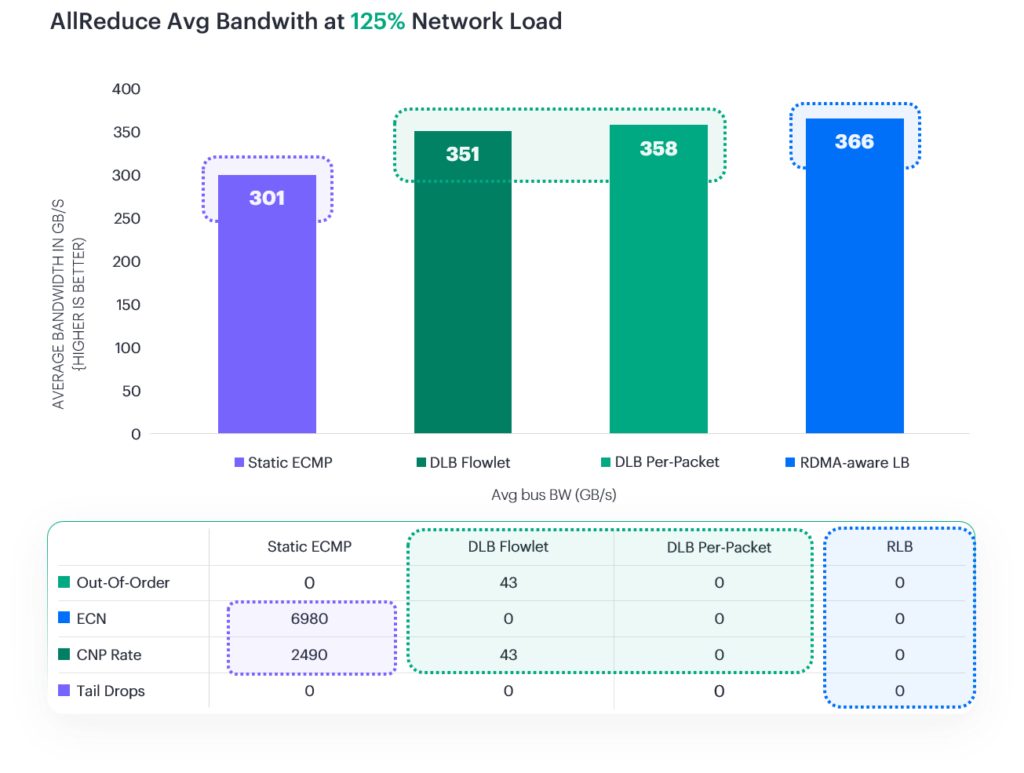
백문이 불여일견, 이번 HPE Discover 2026에서 공개된 실제 벤치마크 성능 데이터를 함께 보시죠.
네트워크에 의도적으로 125%의 극한 과부하를 준 테스트 결과입니다.
기존 내비게이션 방식(Static ECMP)은 네트워크 혼잡 메시지(ECN)가 무려 6,980건이나 터지며 평균 대역폭이 301GB/s 수준으로 뚝 떨어집니다. 반면 이론상 완벽하다던 패킷 스프레이(DLB Per-Packet/MRC) 방식은 패킷을 쪼개고 처리하는 오버헤드 때문에 358GB/s에 그쳤죠.
하지만 맨 우측의 RLB 환경을 보십시오. 평균 대역폭 366GB/s라는 압도적인 최고 속도를 뿜어냅니다.
가장 소름 돋는 부분은 하단 테이블입니다. 혼잡 메시지(ECN)와 혼잡 통지CNP Rate)가 모두 ‘0’입니다. 서버 단에 패킷 재정렬을 위한 비싼 전용 NIC를 강제하지도 않으면서(Any NICs), 오직 스위치 아키텍처의 영리함만으로 네트워크 혼잡과 패킷 유실을 완벽하게 ‘제로’로 통제해 버린 것입니다.
🧩 퍼즐 2. Scale-Up: AMD Helios AI 랙, 이더넷으로 1조 개 파라미터 장벽을 깨다
어디를 연결하나? 단일 서버 내부의 GPU와 GPU 사이의 연결
지금까지 단일 서버나 하나의 랙 안에서 GPU끼리 초고속으로 소통하는 Scale-Up 영역은 엔비디아 NVLink처럼 비싸고 폐쇄적인 ‘전용 독점 도로’였습니다. 다른 회사 장비를 끼워 넣을 수도 없고 비용도 엄청나게 비쌌죠.
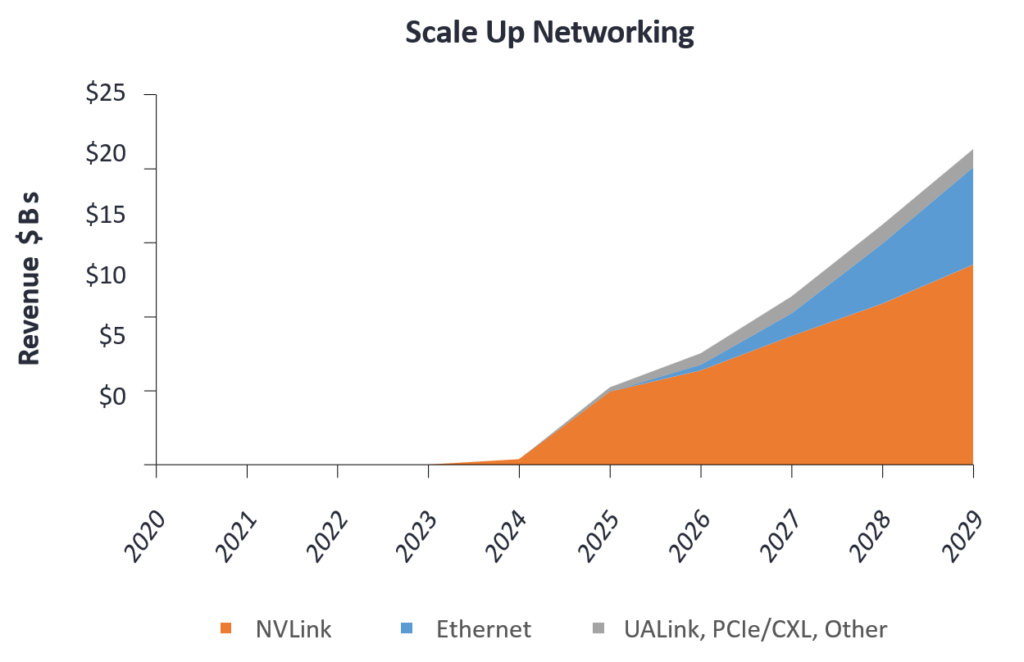
하지만 아래의 Scale-Up 네트워킹 시장 매출 예측 전망치를 보면, 시장의 판도가 급격하게 뒤흔들리고 있음을 알 수 있습니다.
Source: 650 Group
그래프를 보시면 불과 2025년 이전까지만 해도 주황색으로 표시된 NVLink(독점 기술)가 이 시장을 거의 100% 독식하고 있었습니다. 하지만 2026년 현재를 기점으로 파란색의 ‘오픈 이더넷(Ethernet)’ 패브릭 영역이 폭발적으로 도약하며 거대한 지각변동을 일으키고 있는 것이 명확히 보입니다.
그리고 무섭게 치고 올라오는 파란색 그래프의 중심에는 바로 HPE의 AMD “Helios” AI 랙(AI Rack) 솔루션이 있습니다.
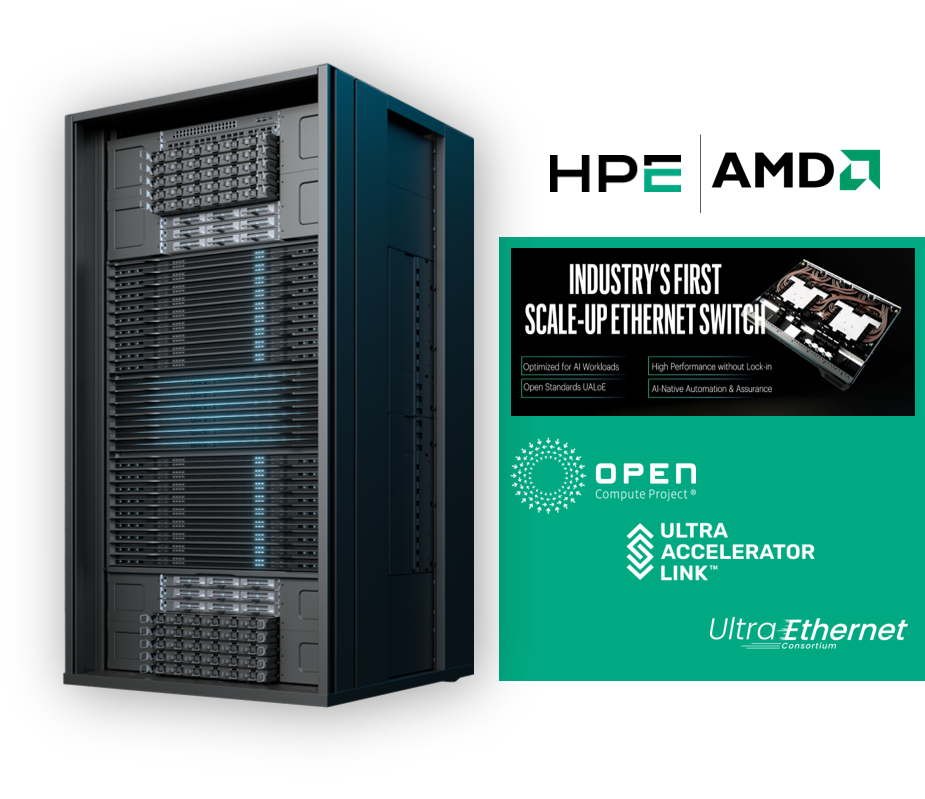
HPE와 AMD가 협력하여 선보인 AMD “Helios” AI 랙의 실체입니다.
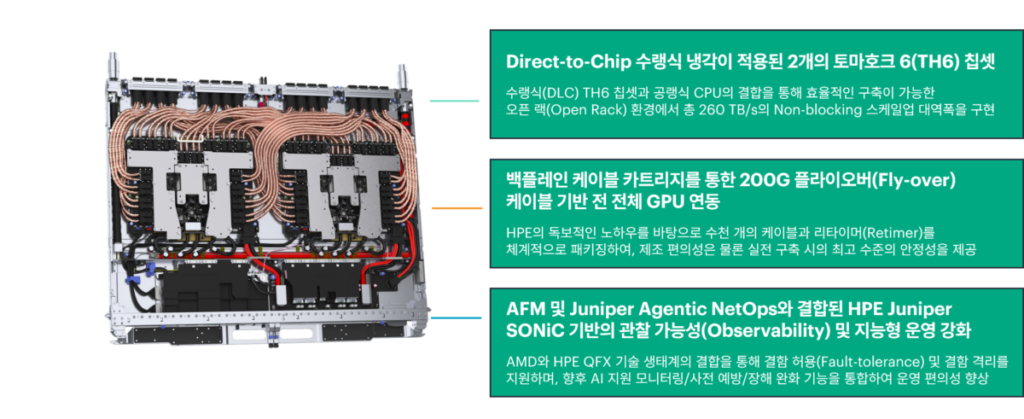
이 아키텍처는 비싸고 폐쇄적인 독점 기술(NVLink) 대신, 우측 상단에 보이는 업계 최초의 수랭식 이더넷 스케일업 스위치 트레이(Switch Tray)를 Compute 시스템 내부로 직접 결합했습니다.
OCP(Open Compute Project) 표준과 UEC(Ultra Ethernet Consortium) 규격, 그리고 UALoE(Ultra Accelerator Link over Ethernet) 기술을 집약하여, 무려 72개의 대형 GPU를 하나의 개방형 패브릭으로 묶고 260 TB/s라는 경이로운 스케일업 대역폭을 이더넷으로 달성해 냈습니다.
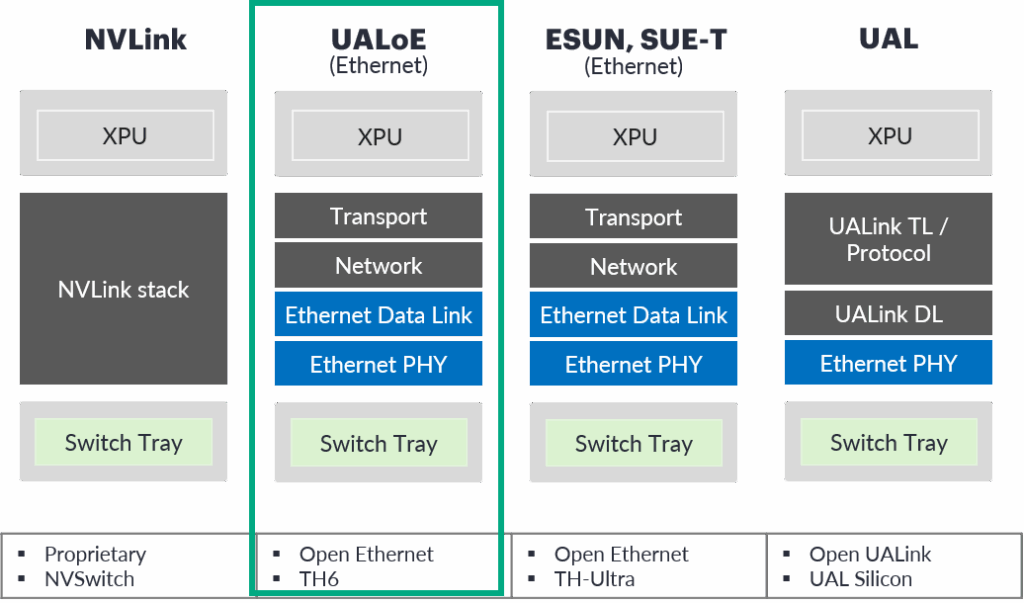
이 지형도의 행간을 읽어보면 아주 흥미로운 진화 단계가 보입니다. 궁극의 미래 표준인 ESUN으로 가려면 차차기 엔진인 ‘토마호크 울트라(TH-Ultra)’ 칩셋이 필요하다는 전제조건이 붙습니다.
그 미래가 오기 전까지 특정 벤더의 독점 장벽을 깨고 개방형 표준으로 넘어가기 위해, 현재 시점에서 가장 강력한 브릿지(Bridge) 역할을 수행하는 실전 무대가 바로 Broadcom Tomahawk 6(TH6) 기반의 UALoE 아키텍처입니다.
HPE는 이를 구현하기 위해QFX5250(TH6 기반)의 수랭식 냉각 기술을 랙 맞춤형 ‘스위치 트레이(Switch Tray)’ 형태로 Helios 내부 시스템에 직접 blind-mate 결합시켰습니다.
업계 최초: 표준 기반의 HPE Networking 이더넷 스케일업 스위치
위 다이어그램에서 보시듯, 이 스위치 트레이 내부에는 2개의 TH6 칩셋을 식히는 100% Direct-to-Chip 수랭식 기술과 안전한 PG25 냉매는 물론, 수천 개의 200G 케이블을 한 오차 없이 묶어주는 백플레인 카트리지가 장착되어 있습니다.
여기에 HPE Juniper SONiC OS와 AI 기반 지능형 NetOps 소프트웨어까지 결합되어 극상의 안정성과 관찰 가능성(Observability)을 완성했죠.
특정 벤더의 폐쇄적인 멤버십 도로(NVLink) 대신, 누구나 참여할 수 있는 열린 이더넷 고속도로 위에서 AI 연산 효율을 극대화하겠다는 선언! 이것이 바로 우리가 맞춘 두 번째 Scale-Up의 퍼즐입니다.
🧩 퍼즐 3. Scale-Across: PTX·MX 라우터로 국경과 데이터센터의 경계를 허물다
어디를 연결하나? 지리적으로 분산된 데이터센터, 클라우드, 그리고 사용자 간의 광역망(WAN) 연동
마지막 세 번째 퍼즐은 하나의 데이터센터를 넘어, 수백~수천 킬로미터 떨어진 원격지 데이터센터나 인퍼런스 에지(Edge) 인프라를 하나로 묶어주는 Scale-Across 영역입니다.
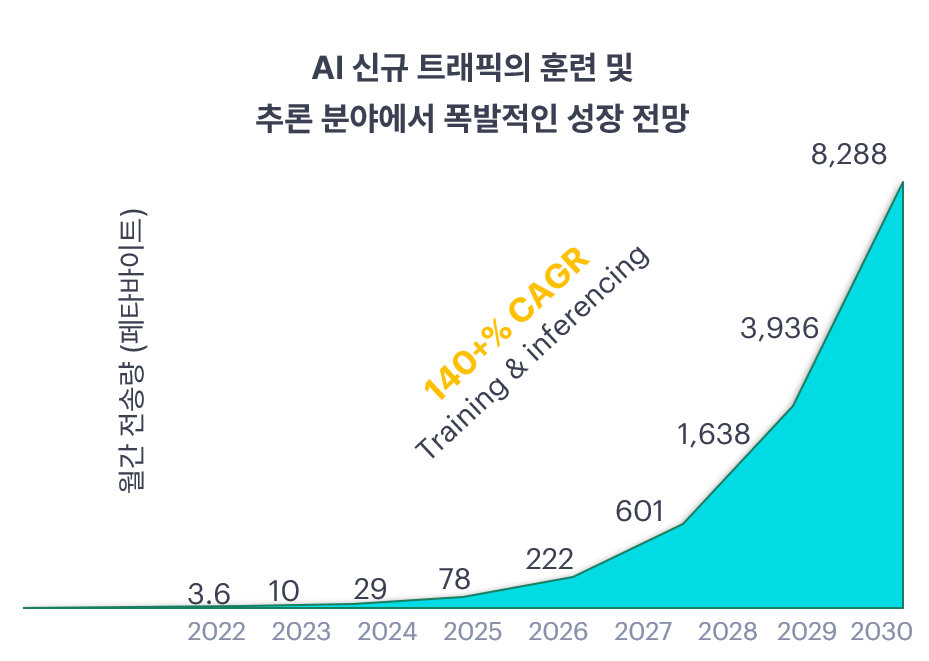
글로벌 시장조사기관 옴디아(Omdia)와 HPE의 조사에 따르면, AI 학습 및 추론 트래픽은 연평균 140% 이상(CAGR 140%+)이라는 미친 속도로 폭발적 성장을 이어가고 있습니다.
단순히 트래픽만 늘어나는 것이 아닙니다. 이제 AI는 단일 클러스터 안에서 해결할 수 있는 문제를 넘어섰습니다. 기업들이 AI 데이터센터를 광역망(WAN)으로 분산시킬 수밖에 없는 현실적인 4대 장벽이 존재하기 때문입니다.
전력 및 공간의 한계: 단일 데이터센터가 감당할 수 있는 전력 전력량과 랙 공간이 한계에 도달했습니다.
연산 및 메모리 한계: 1조 개 파라미터급 모델을 단일 장소에서 처리하기 어려워졌습니다.
지연 시간 및 신뢰성: 사용자 근접 지역에서 초저지연 추론 서비스를 제공해야 합니다.
데이터 주권 및 규제: 국가별 데이터 규제 법안을 준수하기 위해 데이터를 현지에 분산 보관해야 합니다.
결국 아래와 같은 명제가 성립하게 됩니다.
“AI가 지리적으로 분산되는 순간, 전체 시스템의 성능은 라우팅과 WAN 네트워크가 좌우한다” Once AI is distributed, performance becomes network-centric
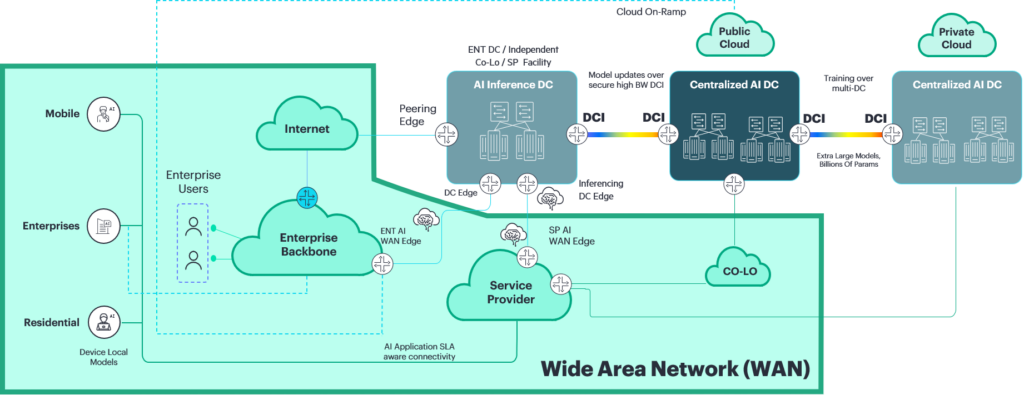
위 아키텍처 맵을 보시면 Scale-Across의 실체가 명확히 보입니다.
중앙 AI 데이터센터 간의 대규모 분산 학습(Training over multi-DC)부터, 중앙 데이터센터에서 업데이트된 모델을 지역별 추론 데이터센터(AI Inference DC) 및 통신사(SP) 에지망으로 실시간 배포하는 흐름까지, 모두 광역망(WAN)을 거치게 됩니다.
하지만 일반적인 이더넷 스위치나 인피니밴드는 먼 거리로 나가는 순간 순간적인 AI 트래픽 폭증(Incast/Burst)을 감당하지 못해 패킷 유실과 지연이 터지게 됩니다.
이 경계선에서 DC의 관문을 지키고 장거리 고속도로를 뚫어주는 주역들이 바로 MX 및 PTX 시리즈 코어 라우터입니다.
추론 에지 및 외부망 관문 (MX 라우터): Peering Edge 및 Inference DC 관문에는 MX 시리즈(MX301 등)를 전면에 배치하여 엔터프라이즈 및 통신사망으로 나가는 트래픽을 안전하고 유연하게 제어합니다.
초고속 DCI 및 WAN 백본 (PTX 라우터): 데이터센터 간 연동(DCI) 구간에는 무려 36포트의 800GE 대역폭을 2RU 폼팩터로 뿜어내는 PTX10002-36QD 라우터 등을 배치합니다. 대용량 Deep Buffer와 SRv6 기반 Traffic Engineering으로 광역망 통신 시 발생하는 트래픽 버스트를 완벽하게 받아내게 됩니다.
트랜스폰더 없는 비용 혁신 (Coherent Optics): 비싸고 무거운 광전송 장비(WDM) 없이, PTX 라우터 포트에 직접 모듈만 꽂아 최대 2,000km까지 800G 속도로 쏠 수 있는 차세대 코히어런트 광모듈(JCO800 ZR/ZR+)을 연동하여 DCI 구축 비용을 획기적으로 절감합니다.
내부의 오픈 이더넷(QFX) 패브릭을 광역 코어 라우팅망(PTX/MX)으로 끊김 없이 매끄럽게 연결하여, 데이터센터 간의 물리적 장벽을 지우고 AI 연산 패브릭을 지구 스케일로 확장하는 기술! 이것이 우리가 완성한 세 번째 퍼즐, Scale-Across입니다.
한눈에 보는 차세대 AI 네트워킹 핵심 요약
오늘 다룬 AI 데이터센터 패브릭의 3대 퍼즐을 한눈에 기억하실 수 있도록 깔끔하게 표로 정리해 드립니다.
구분
연결 영역 (Where)
핵심 기술 & 특징 (How)
일상적 비유
HPE 주니퍼 핵심 솔루션
Scale-Out
서버 ↔ 스위치 (백엔드 네트워크)
UET/RoCEv2 기반 혼잡 제어 및 패킷 재전송 최소화
막히는 차선을 피해 실시간 분산 배송하는 최첨단 내비게이션
QFX5240 (800G) 및 독보적인 RLB 알고리즘
Scale-Up
GPU ↔ GPU (랙/서버 내부)
UALoE 기반 오픈 이더넷 스케일업 및 Direct-to-Chip 수랭식 기술
비싼 독점 통행료를 걷어낸 완벽한 개방형 고속도로
AMD Helios AI 랙 & QFX5250 (1.6T 수랭식 스위치 트레이)
Scale-Across
DC ↔ DC / WAN (지구 스케일 확장)
대용량 Deep Buffer, Traffic Engineering 및 코히어런트 광통신
트랜스폰더 없이 대륙을 직접 이어주는 대용량 광역 터널
PTX10002 / MX 라우터 & JCO800 ZR/ZR+ 광모듈
이더넷은 항상 “느리고 패킷 유실에 취약하다”는 오해와 싸워왔습니다.
하지만 Scale-Out에서의 지능적인 혼잡 제어(RLB), Scale-Up에서 독점 생태계(NVLink)를 깨부수는 오픈 이더넷 랙 인프라(AMD Helios & QFX5250), 그리고 Scale-Across에서 데이터센터의 경계를 지우는 초고속 코어 라우팅(PTX/MX)까지!
HPE가 완성한 개방형 표준 패브릭을 통해 이더넷은 이제 명실상부한 AI 데이터센터 백엔드의 가장 강력한 주인공으로 자리 잡았습니다.
폐쇄된 독점 멤버십 도로 위에 갇힐 것인가, 아니면 지속 가능한 오픈 이더넷 고속도로 위에서 자유롭게 날아오를 것인가?